


芯东西(公众号:aichip001)
作者 | 崔嫄伟
编辑 | 陈骏达
芯东西10月14日报道,昨日,上海3D存算一体AI芯片公司思敏威集成电路有限公司宣布完成约亿元天使轮融资。同时该公司称其第一代3D堆叠量产芯片青衡3D-HPU流片在即,正从核心技术研发进入产品化和客户应用阶段。
本轮融资由中兴通讯战略投资,博华产投、松青资本、建信信托、合创资本等机构联合投资,老股东德同资本追投。该公司称,本轮资金将主要用于支持第二代3D堆叠产品的研发和工程化。
思敏威成立于2024年12月,总部位于上海浦东,其专注于大模型推理场景的高性价比AI芯片研发。核心产品为基于青衡3D-HPU存算融合计算架构的AI推理芯片,技术路线融合SRAM存内计算、3D异质封装近存计算、自研RISC-V计算核心及Chiplet芯粒互联。
据该公司此前披露,思敏威创始团队由多位国际学者和国内RISC-V、GPU芯片工程团队组成,核心成员曾在英特尔、AMD、华为海思及国内一线AI芯片公司任职,主导设计并量产过多款芯片,累计量产数亿颗。
同时该公司团队有超过20年SoC芯片及系统软件研发经验,在先进存储器件及存算一体SoC方向有超过10年研究积累,完成超过20次流片验证,是最早实现2.5D/3D多芯粒存算一体AI芯片的团队之一。2025年团队率先流片验证了支持FP4浮点的存内计算核心IP,近五年在ISSCC、JSSC等集成电路顶会顶刊发表论文11篇。
目前,思敏威成立至今已完成两轮融资。2026年5月,该公司完成近亿元种子轮融资,由东方富海、纪源资本领投,徐汇资本、德同资本、赛智伯乐等跟投。
产品层面,思敏威以青衡3D-HPU存算融合架构为核心,推出统一高带宽3D AI推理计算基座3D-cHMC(3D-computing Hyper Memory Cube)。
该基座通过多层3D DRAM与计算层垂直堆叠,依托TSV垂直互联构建高密度数据通路,结合原生FP4浮点数字存算一体提升算力密度,并以Chiplet高速互联支持多Stack扩展。
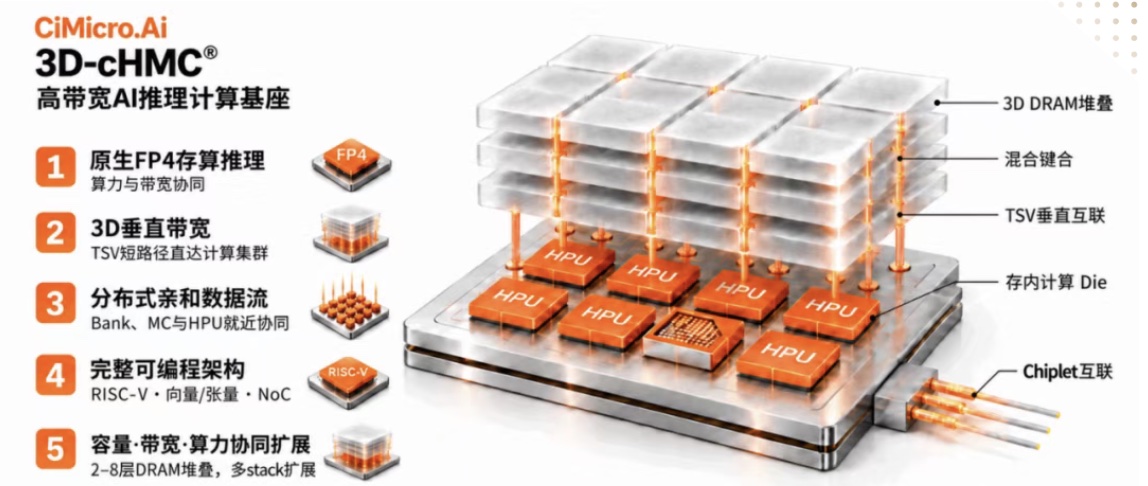
▲3D-cHMC高宽带AI推理计算基座解析图(图源思敏威)
围绕3D-cHMC基座,思敏威正推进智能终端、端侧智能、算力网络、具身智能四条产品线布局。
智能终端方向,该公司基于历经6年、数十次流片验证的全数字SRAM存算一体技术,以计算IP或轻量化芯片形态适配可穿戴、智能音频及AIoT终端,相关技术已进入头部终端客户的定制开发阶段。
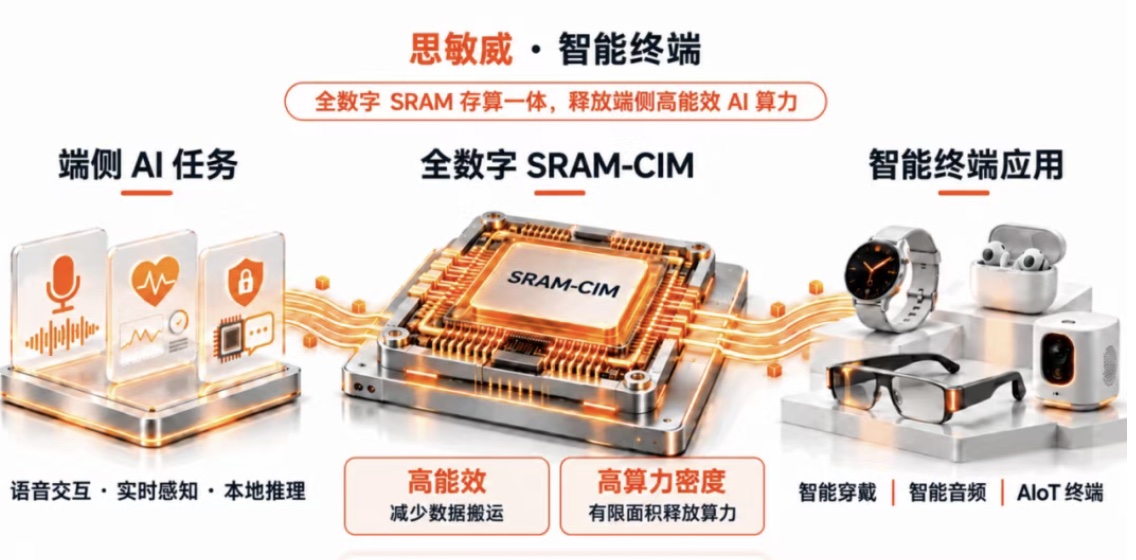 ▲智能终端方向产品布局(图源思敏威)
端侧智能方向,思敏威推进CPU主控与3D-HPU异构推理方案,面向AI PC、AI Box、AI NAS等本地大模型场景,宣称可在设备功耗与空间约束下实现每秒1000个token的推理性能。
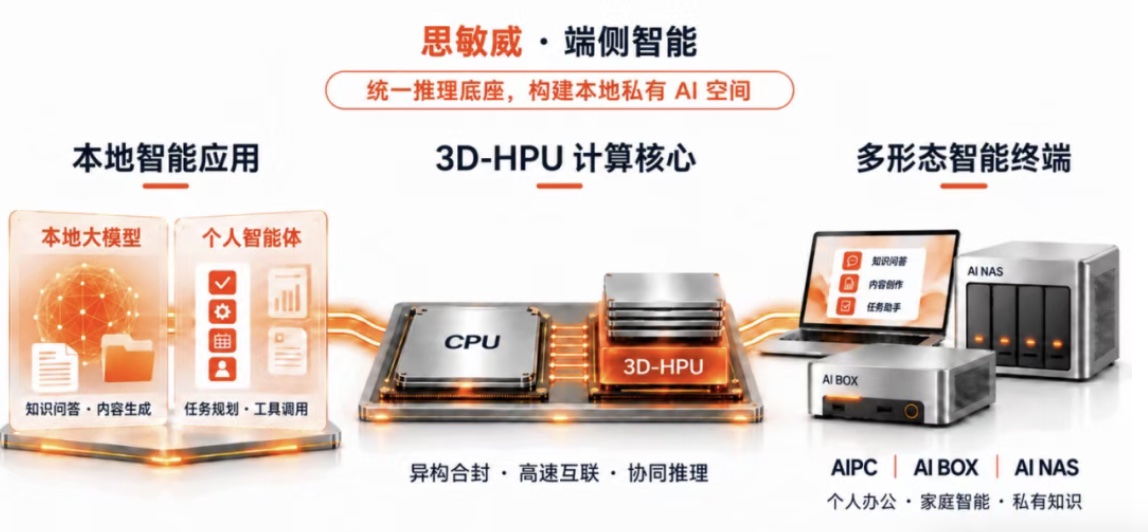 ▲端侧智能方向产品布局(图源思敏威)
算力网络方向,该公司围绕Prefill-Decode分离、Attention-FFN分离,构建3D-HPU与XPU等其他AI计算单元协同的异构推理体系,面向企业私有化部署和私有数据中心。
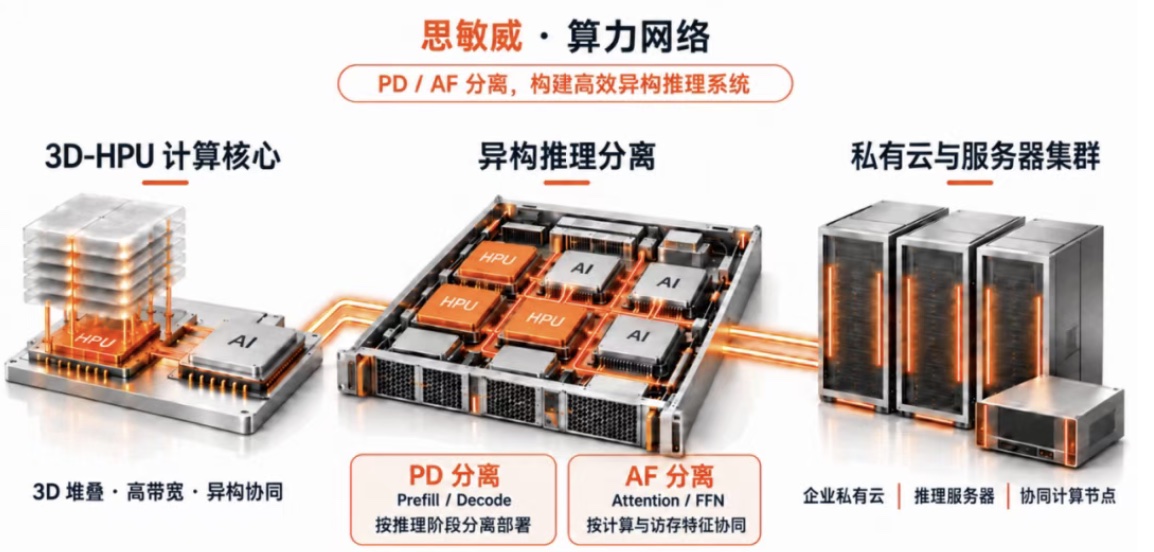 ▲算力网络方向产品布局(图源思敏威)
具身智能方向,思敏威将多模态模型与世界模型的算子及数据流前置到芯片定义中,与机器人客户联合定义“模型—芯片—机器人系统”。
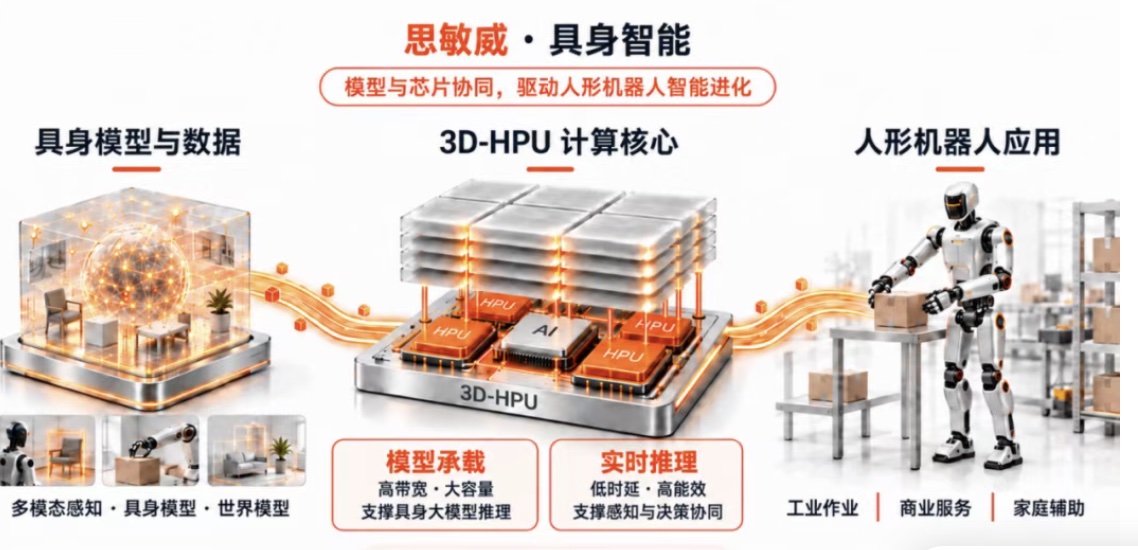 ▲具身智能方向产品布局(图源思敏威)
商业合作方面,该公司透露与大模型基础设施独角兽无问芯穹形成实际商业合作,并与领开半导体达成战略合作,双方将围绕3D堆叠存算融合架构及AF分层推理存储方案联合开发,目标是降低大模型推理对HBM显存的依赖和系统部署成本。
结语:3D存算进入资本密集期,流片兑现仍是关键
思敏威半年内连续完成两轮融资、累计近两亿元,且引入中兴通讯这样的产业战略投资方,反映出3D存算一体赛道正从技术验证走向产业化验证阶段。与微纳核芯、亿铸科技等同行类似,思敏威选择的路线是用3D堆叠架构在成熟工艺上逼近先进制程的算力密度,以对冲国内半导体制造工艺受限的现实。
这一路线的逻辑在AI推理需求爆发的背景下成立:大模型推理对带宽和功耗的敏感度远高于训练,存算一体确实有发挥空间。
但需要看到,思敏威第一代芯片尚未正式流片,团队规模和工程化能力还需要通过实际产品交付来验证。3D堆叠涉及混合键合、TSV、热管理等复杂工程问题,从“数十次流片验证IP”到“量产规模出货”之间还有相当距离。
本轮融资后,思敏威首代芯片能否按时流片、能否通过头部客户验证并拿到批量订单,是检验这轮高估值融资成色的关键。
