



机器人前瞻(公众号:robot_pro)
作者 | 钟宸
编辑 | 漠影
机器人前瞻9月22日报道,今天,继昨日发布首款世界动作模型后,理想Foundation Model团队再次发布在具身领域的三大成果,包括ME-Brain-1.0具身智能系统、MachEmbodied-U0统一理解与生成模型、ME-VLM视觉语言模型。
该团队指出,MachEmbodied-VLM(ME-VLM)为具身认知基础模型,已在综合能力评估中取得第一。同时,理想提供了可端侧部署的4B版本,在小参数规模下取得了有竞争力的指标。
MachEmbodied-U0(ME-U0)则从约5,700小时机器人数据和3,920小时第一视角数据的原始数据池中筛选出约4,200小时用于预训练,仅使用各基准自身提供的监督信号进行适配,该模型便在RoboDojo获得17.66分,并在LIBERO和LIBERO-Plus上分别取得99.1%与81.8%的平均成功率。
理想将ME-Brain-1.0称为“记忆、认知与行动,持续进化的具身智能系统”,并展示了“抓万物1小时超级泛化”与手冲咖啡的长程任务demo。
一、可完成4分钟长程任务,展示一万小时抓万物真机测试
理想将ME-Brain-1.0定位为具身智能系统,首先对这一系统的长程任务完成能力进行了展示。
在视频里,ME-Brain-1.0在收到指令后,会以语音进行回应,还会在操作界面上实时回应,目前的操作进行到哪步了,对步骤状态和完成情况也进行了展示。
而从视频来看,夹爪完成了研磨咖啡粉、冲泡咖啡、将咖啡倒入杯中等共15步操作,且当人类对该系统进行询问时,其还能回答包括做了几杯咖啡、咖啡介绍的问题,整体耗时约4分钟。
此外,理想还展示了“无剪辑一小时连续抓万物真机测试”,覆盖上百种不同形状、尺寸和材质的物体。该公司称,测试期间持续切换23次灯光和15次桌布背景,成功率达100%。
此外,理想还放出了多个demo视频,展示了系统的指令跟随、学习、记忆、主动感知、泛化和精细操作等多方面的能力。
指令跟随方面,当人类说出放置指令后,系统会加载plan-general技能,同时调用不同工具完成指令,整个过程耗时46秒,在抓起和放下时,夹爪都会出现较为明显的停顿,流畅性还有提升空间。
而在学习能力方面,当人类说出“记住我的操作并重复”的指令,该系统会调用工具进行记录。当告诉ME-Brain-1.0操作完毕后,它会继续调用工具进行任务的执行。
ME-Brain-1.0也展现了记忆能力,能够在人类弄乱桌面后、听到“恢复桌面”的指令后,将桌面内已经打乱的物体放回原位。不过,全程仅涉及两个物品和两个固定位置的篮子,凌乱程度并不大。
该系统同时具备主动感知能力,能够在记忆人类指令后,主动感知周围环境是否能够执行任务。视频中,人类让该系统在出现绿色碗后将勺子放进去,ME-Brain-1.0成功完成了任务。
而在最后,理想展示了这一系统的多步精细操作任务能力。视频中,ME-Brain-1.0连续完成了积木定位、抓取与堆叠的任务。
但该系统仅完成了三层积木堆叠,积木位置离夹爪也距离偏近。即便任务较为简单,夹爪还是出现了失误操作,整个操作过程用时也较长,夹爪会出现较多停顿情况。
该系统还具备物品的抓取与放置的泛化能力。在桌面整理任务中,ME-Brain-1.0能够将桌面上杂乱的物品放到篮子中,有时采取双爪轮流夹取物体的策略,有时采取同时夹取物体的策略,总的来说,操作会出现一些失误和较多的停顿,物体摆放也不太整齐,提升空间较大。
理想透露,ME-Brain-1.0通过分层记忆、统一认知与事件驱动动作模型,将任务执行与经验积累连接起来。在这一架构下,记忆保存执行依据,认知负责规划、验证和经验利用,动作模型则将决策落实为物理操作,三者共同支持长程任务中的历史调用与策略调整。
同时,这一模型以Evolvable Memory、Cognitive Core 与Action Model三个模块,构建了“动作执行—经验获取—经验进化—动作执行”的自进化闭环。
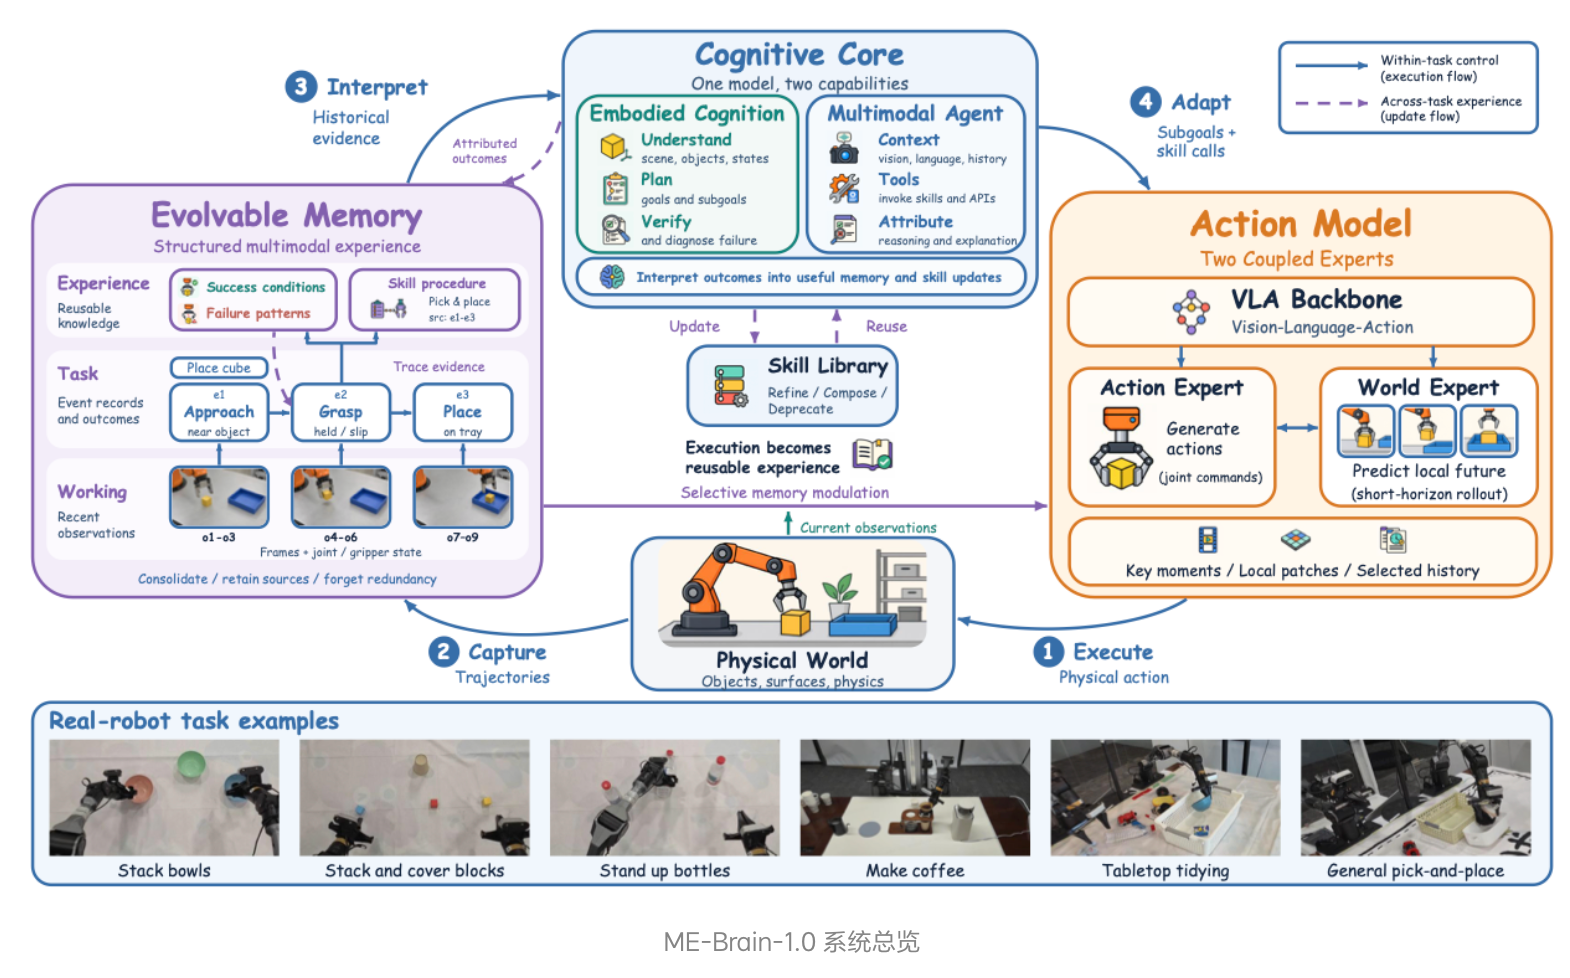
理想称,Evolvable Memory依托Cognitive Core,已在M100端侧芯片上完成模型迁移与定制化优化,支持在本地完成记忆生成、存储、演化和调用。
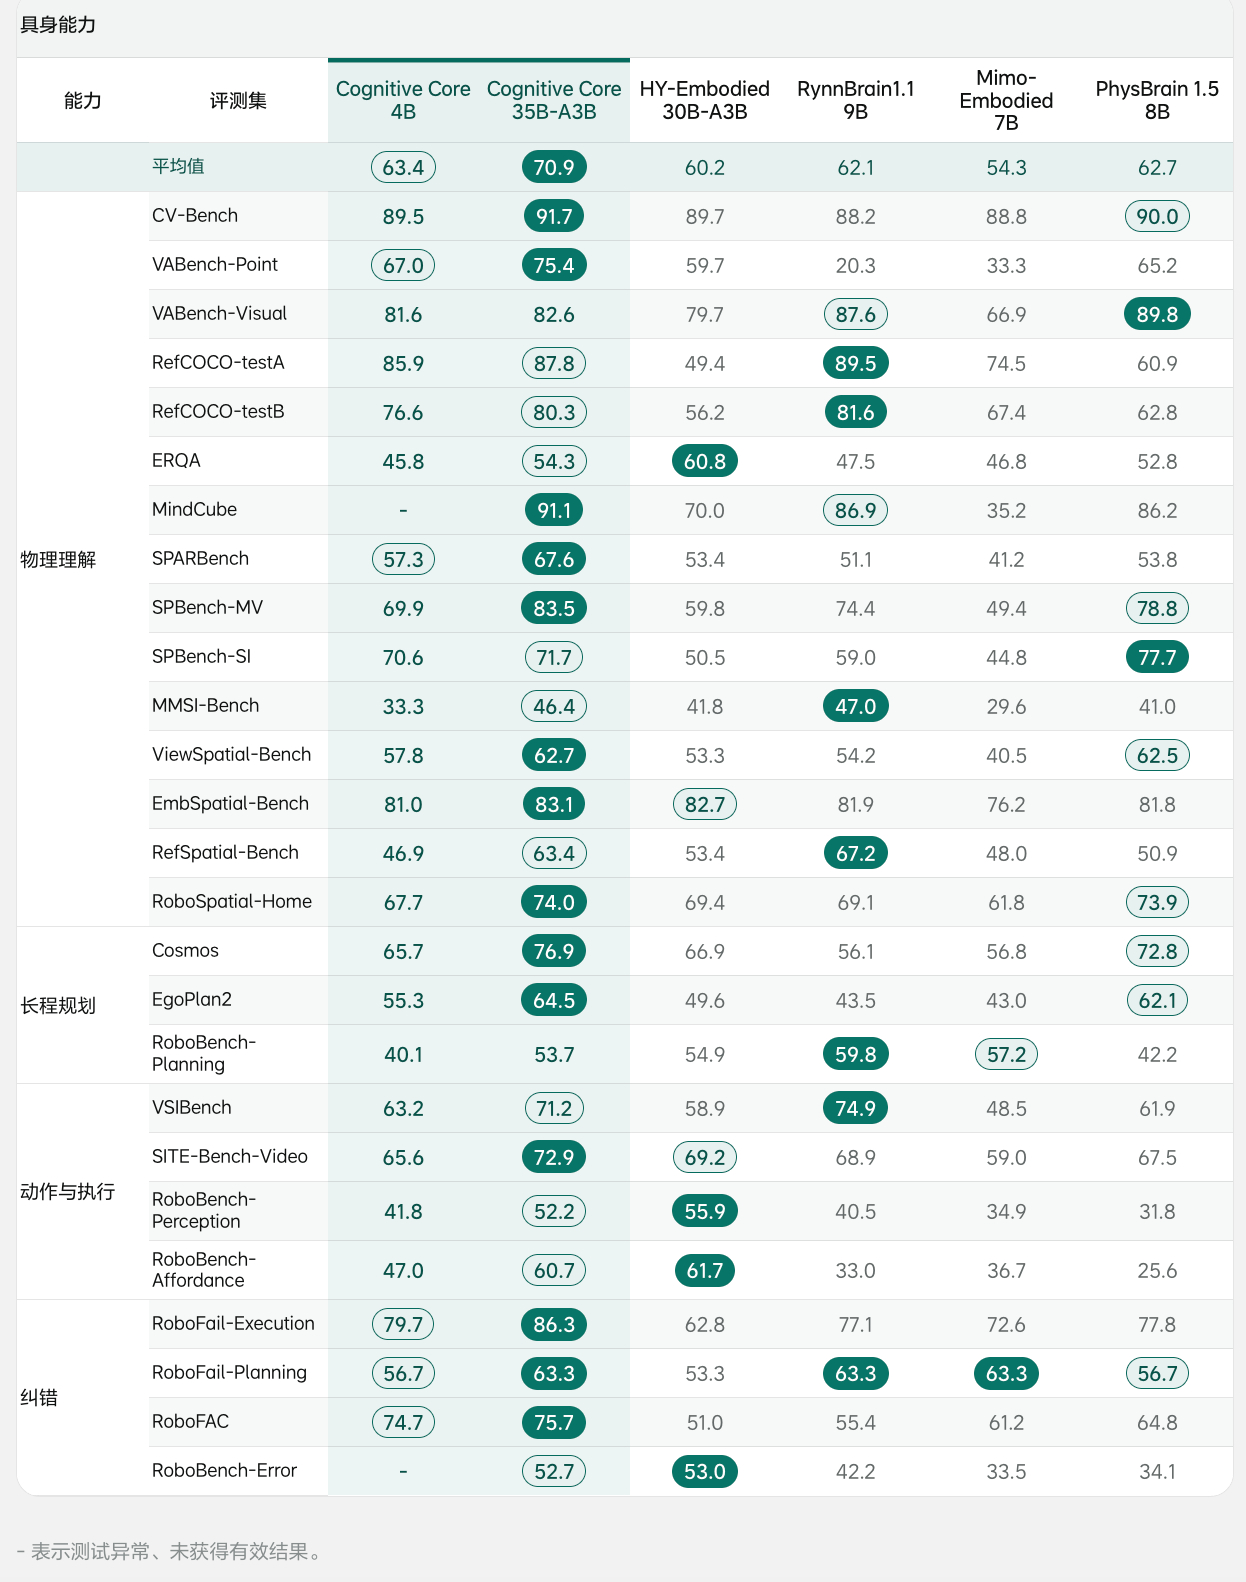
在覆盖物理理解、长程规划、动作与执行、纠错四类能力的具身评测中。Cognitive Core 35B-A3B在14项基准评测上取得最高分,平均分为70.9,领先同类模型8.2分;面向端侧的4B平均分为63.4,位列第二。
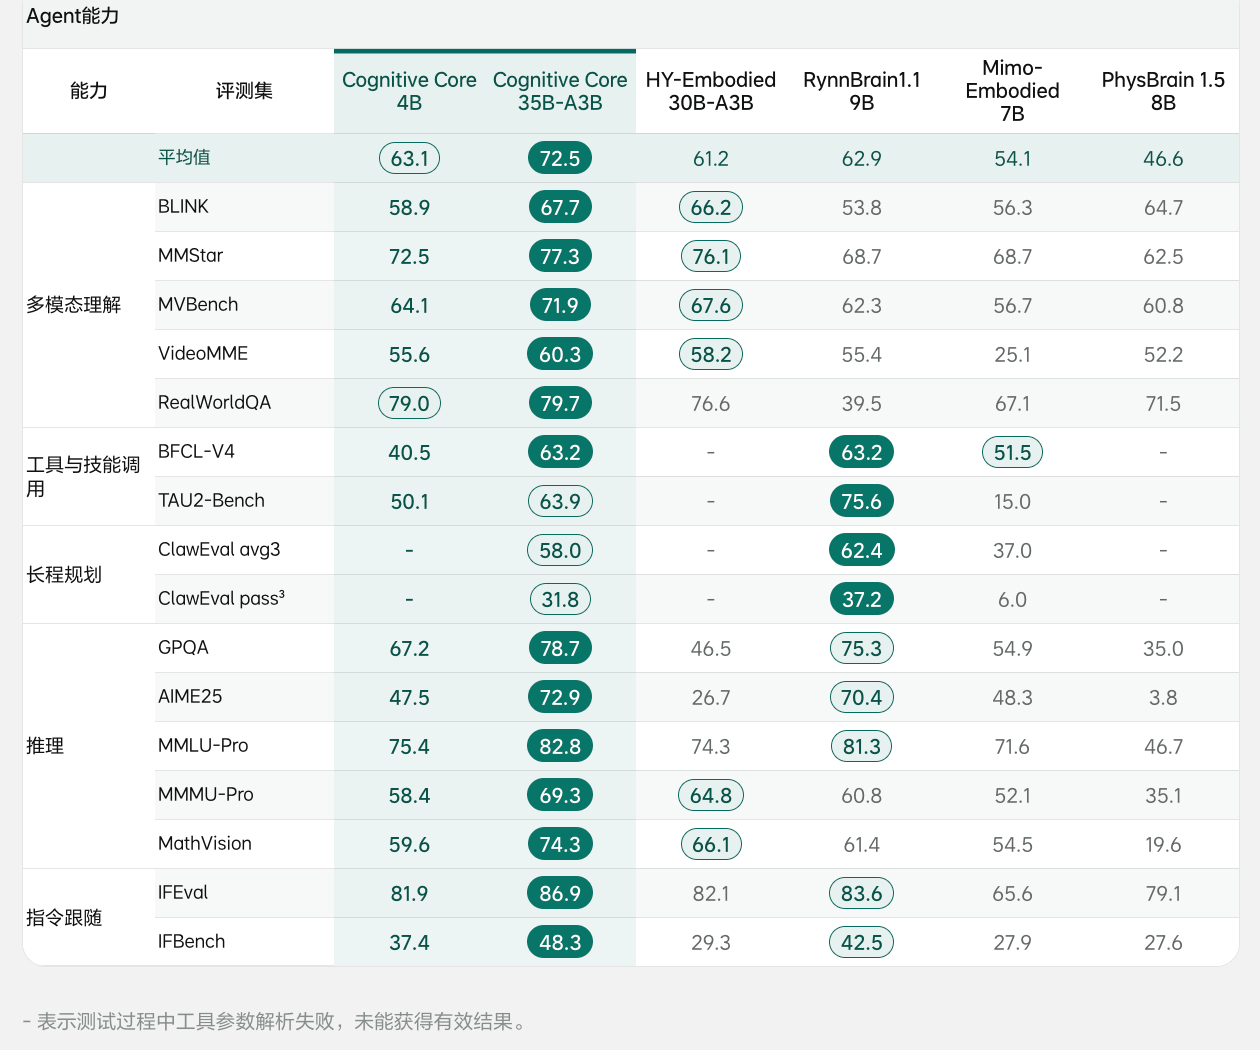
Agent评测覆盖多模态理解、工具与技能调用、长程规划、推理、指令跟随五类能力,共16项基准。Cognitive Core 35B-A3B在其中的13项基准上取得最高分,平均分为 72.5,位列第一;面向端侧的4B平均分为63.1,位列第二。
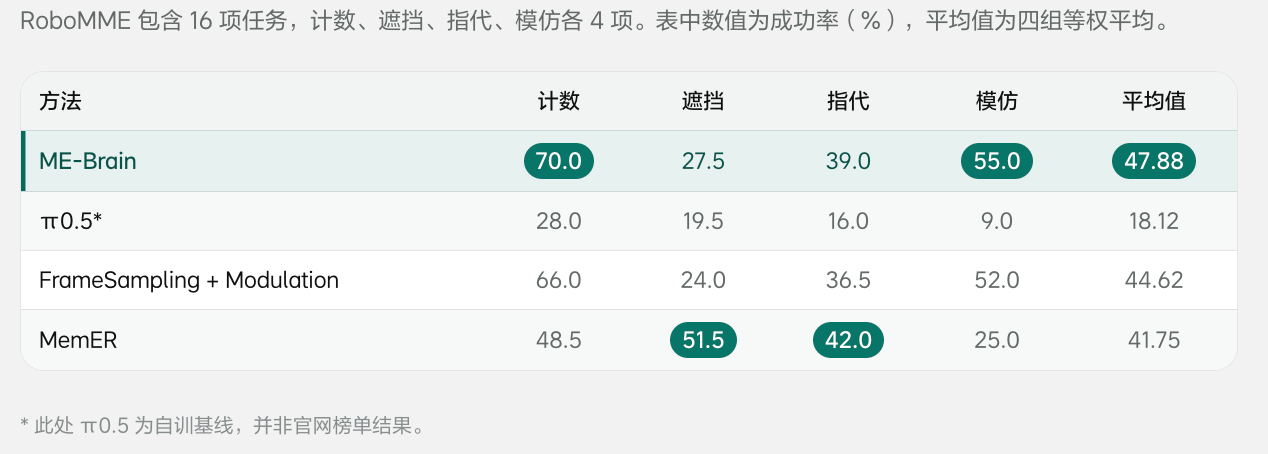
RoboMME包含16项任务,ME-Brain在其中两项领先,平均值位列第一。
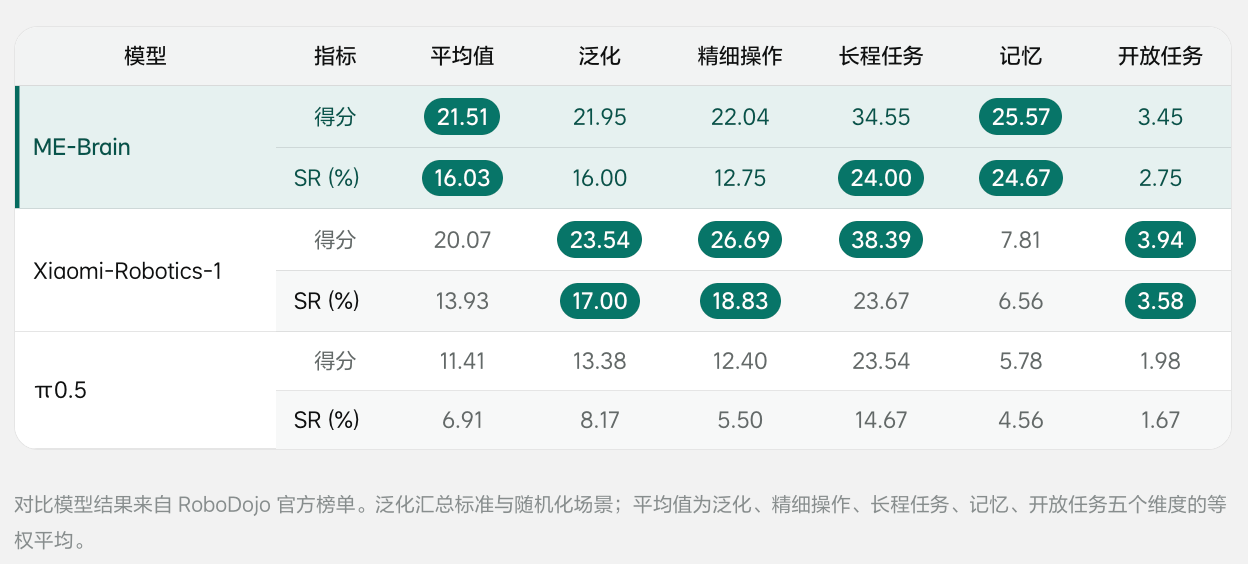
RoboDojo评测中,ME-Brain的平均得分为21.51,平均成功率为16.03%,五个维度的得分与成功率均超过π0.5,但在开放任务上得分和成功率仍不高,低于小米的模型。
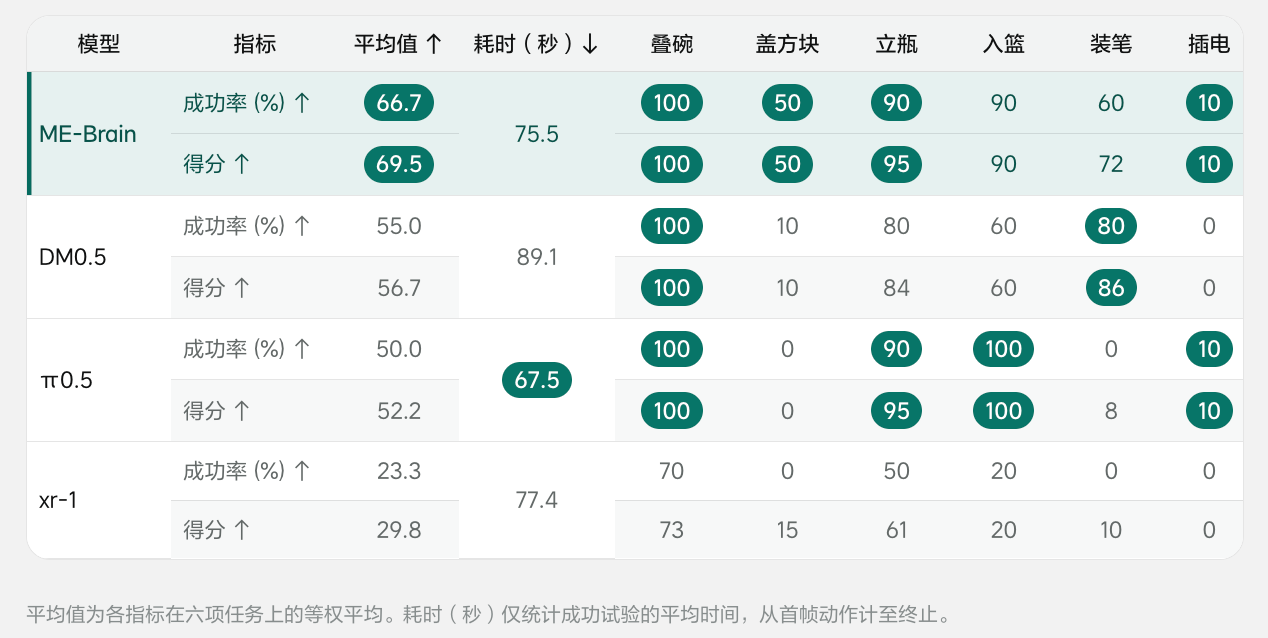
真机评测层,ME-RealBench在Piper双臂机器人上评测了六项任务,由3位评审按双盲流程独立打分后取平均,采用RoboDojo的评分标准,ME-Brain在成功率和得分平均值上出现明显领先,但在耗时上高于π0.5。
对于这一系统,理想称,后续工作将围绕三个方向展开:完善长时记忆的压缩、遗忘与跨任务检索机制;加强Cognitive Core在开放环境中的主动感知、失败归因和技能更新能力;进一步优化Action Model的事件预测与端侧推理效率。
评测方面,该公司将补充长时运行、环境变化和技能复用的对照与消融实验,明确记忆和技能更新对任务完成率、恢复能力及资源开销的影响。
二、4,200小时数据预训练,采用双专家架构
与这一系统同步推出的,还有MachEmbodied-U0(ME-U0)统一理解与生成模型。
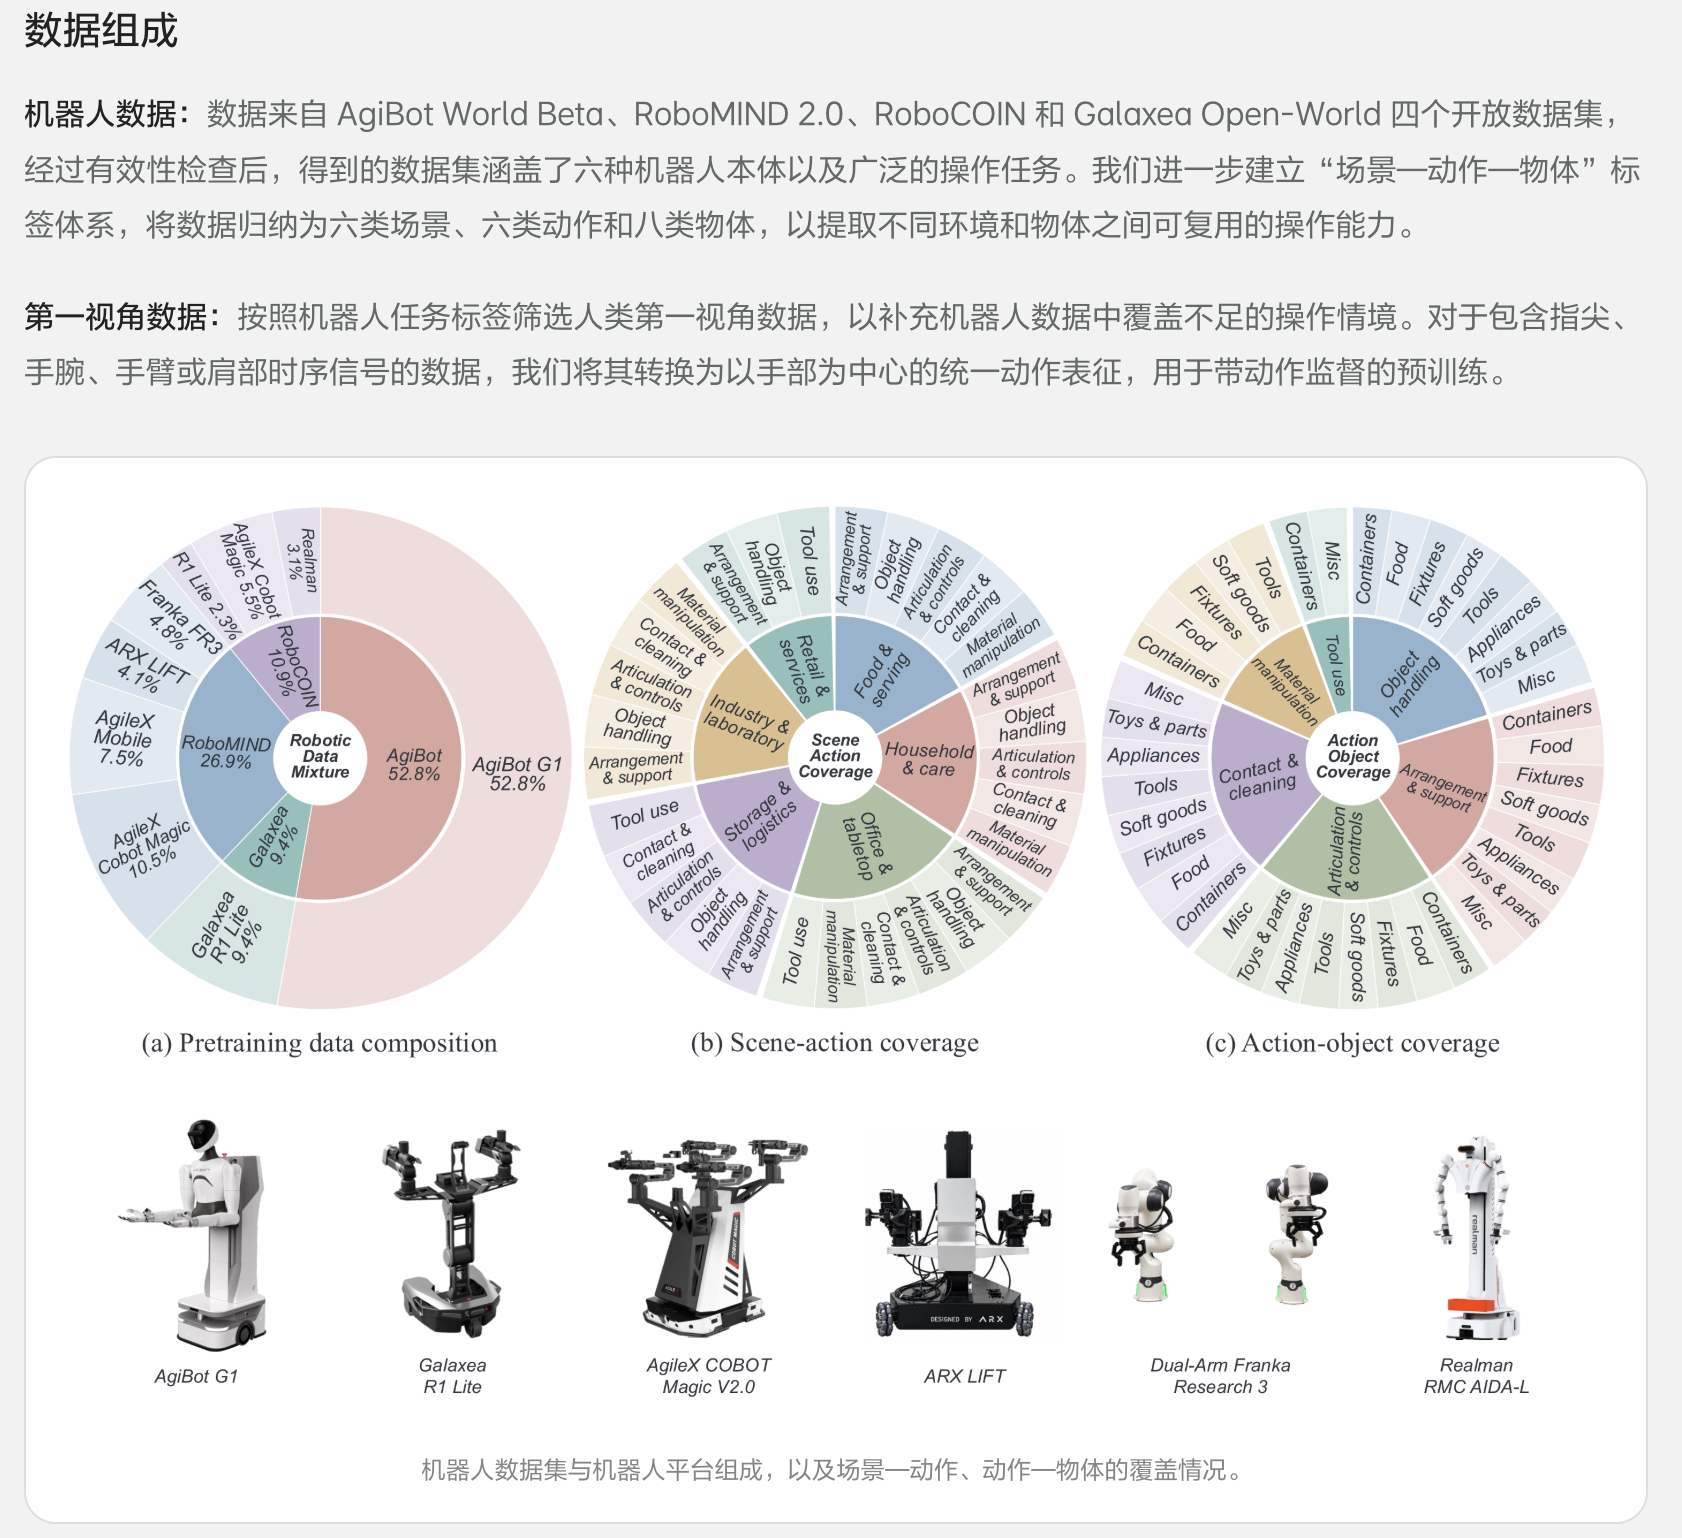
理想从约5,700小时机器人数据和3,920小时第一视角数据的原始数据池中筛选出约4,200小时数据用于预训练,并配套构建统一的状态—动作语义、多模态自动标注、任务感知采样与可扩展的视频训练基础设施。
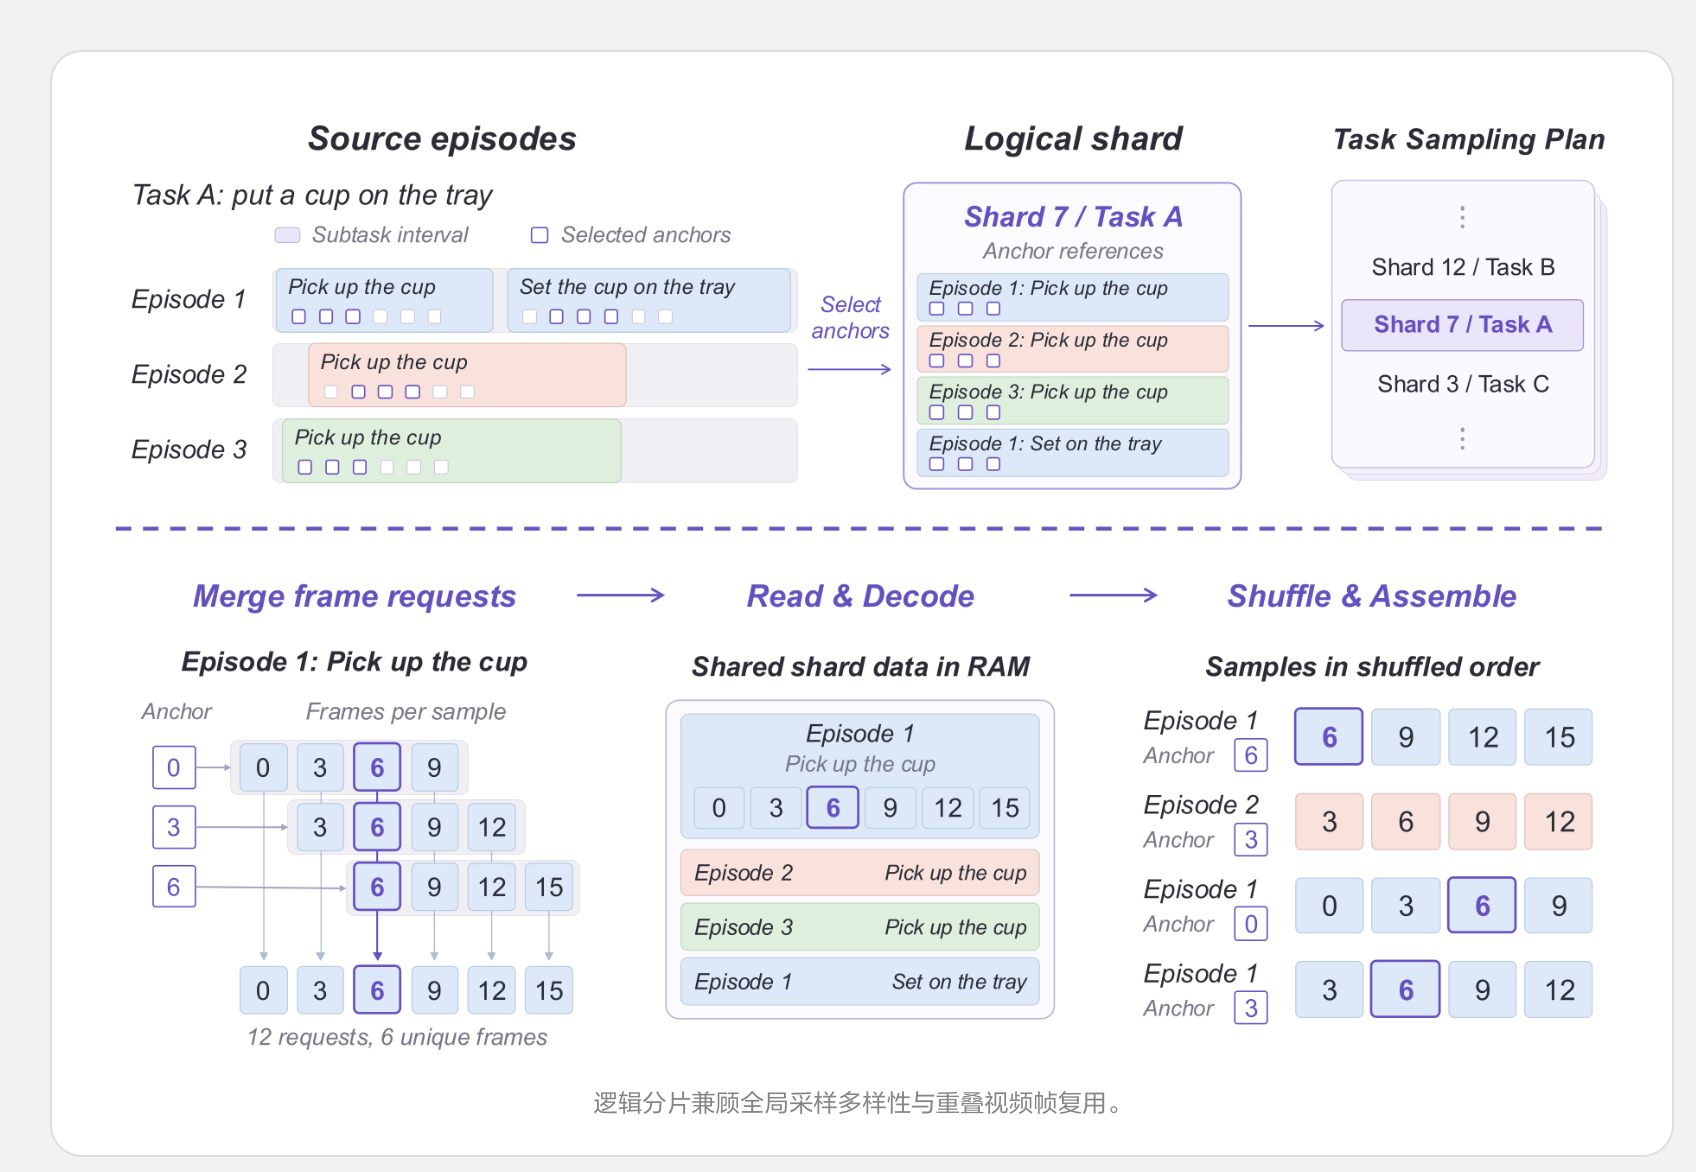
据悉,训练基础设施通过预先生成的轨迹清单、子任务索引与轻量级读取器,将完整混合数据集的初始化时间从约一小时缩短至十分钟以内。
同时,逻辑分片把不同轨迹片段中相邻的采样锚点组织为训练单元,合并重叠的视频帧请求,确保每个视频帧仅解码一次;独立的CPU任务还可根据训练调度预先准备数据,并写入容量受限的共享缓存。
理想透露,在技术报告所采用的配置下,这些优化使总训练时间缩短了30%以上。
理想并未放出这一模型的实机演示视频,但展示了评测结果数据。
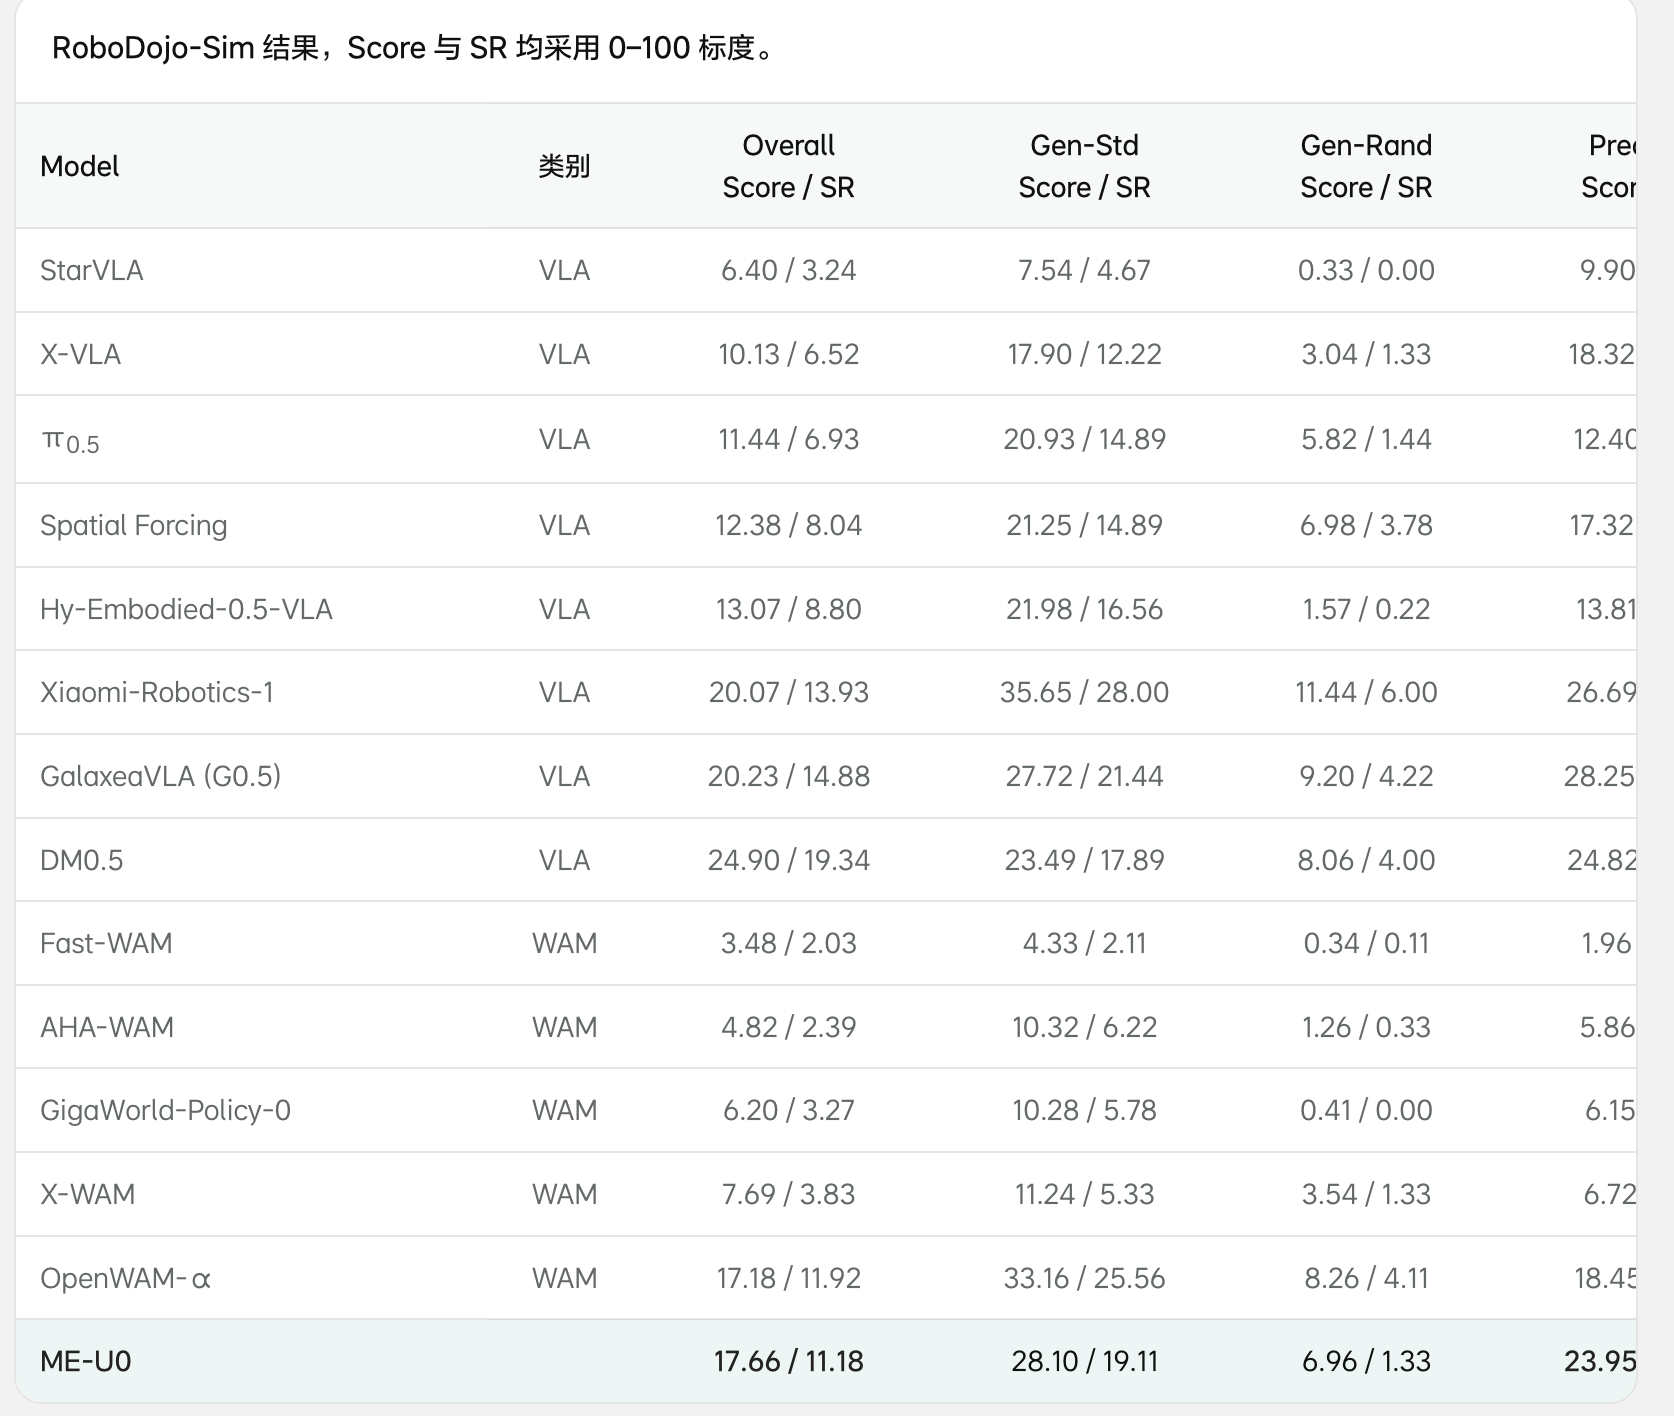
在42项RoboDojo-Sim任务上,理想称,ME-U0取得参评WAM中最好的整体结果:过程得分17.66、成功率11.18%。
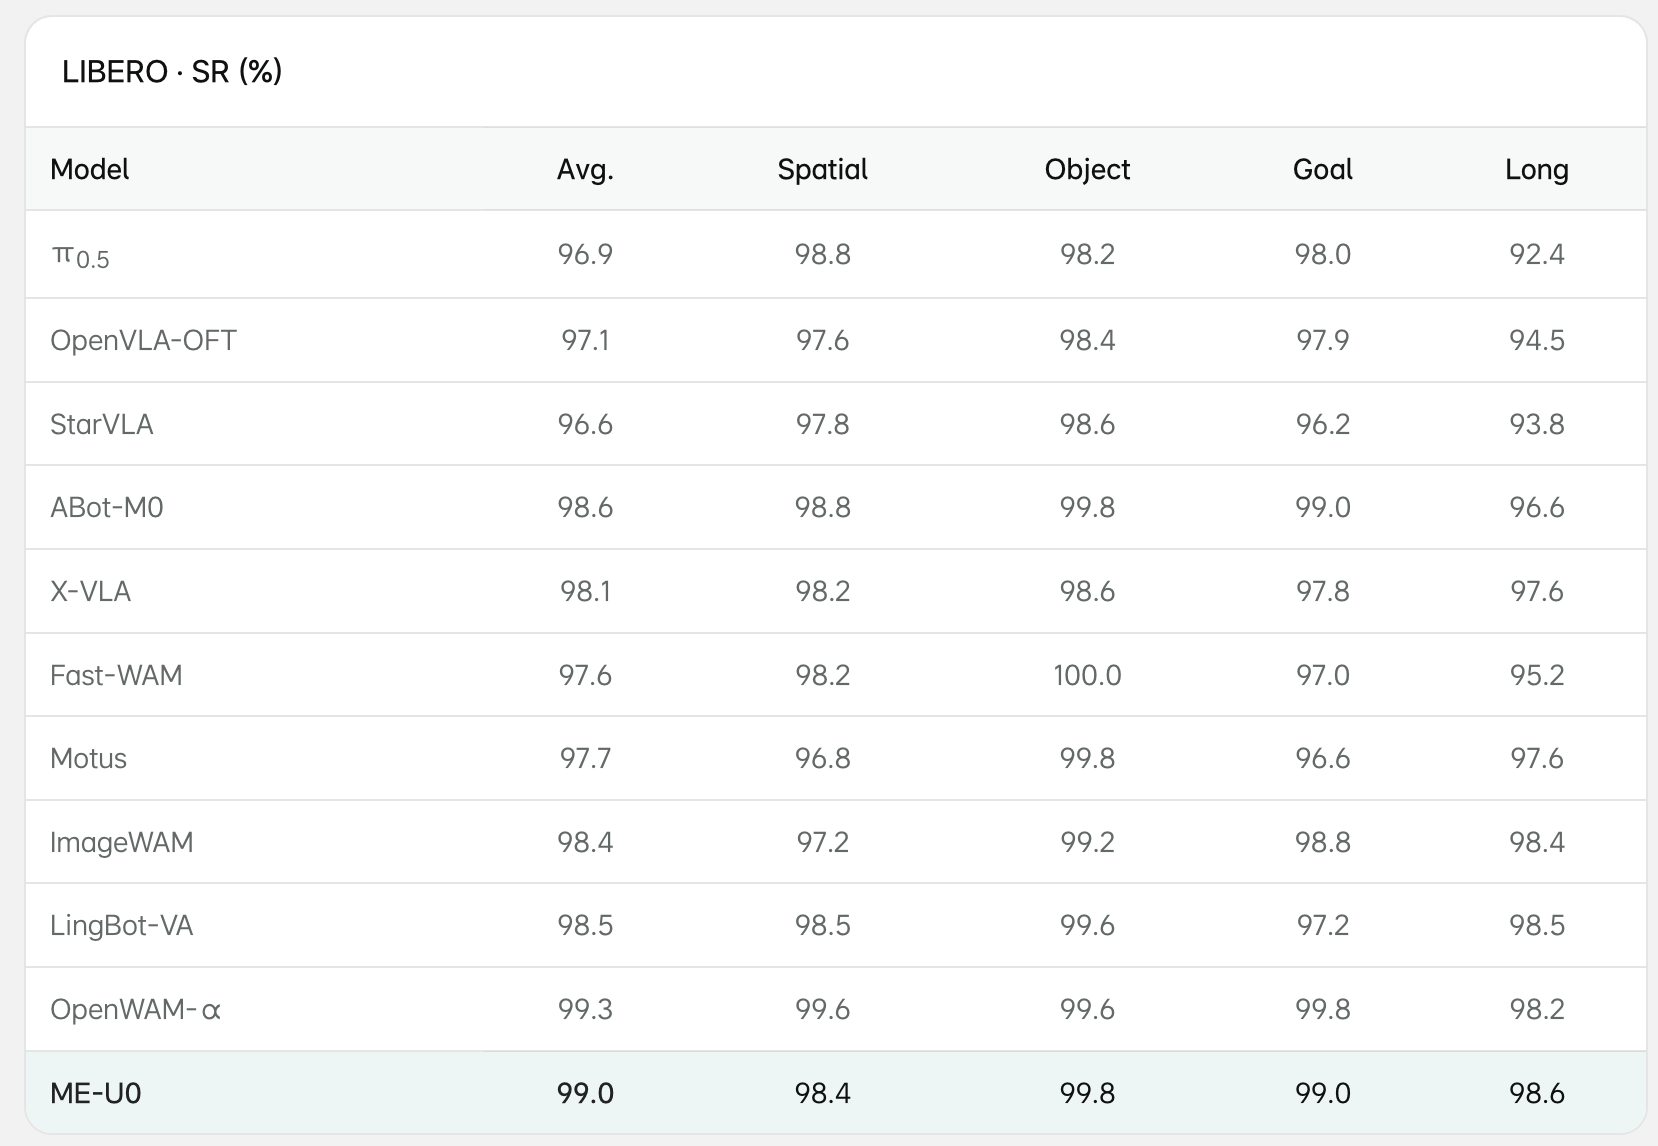
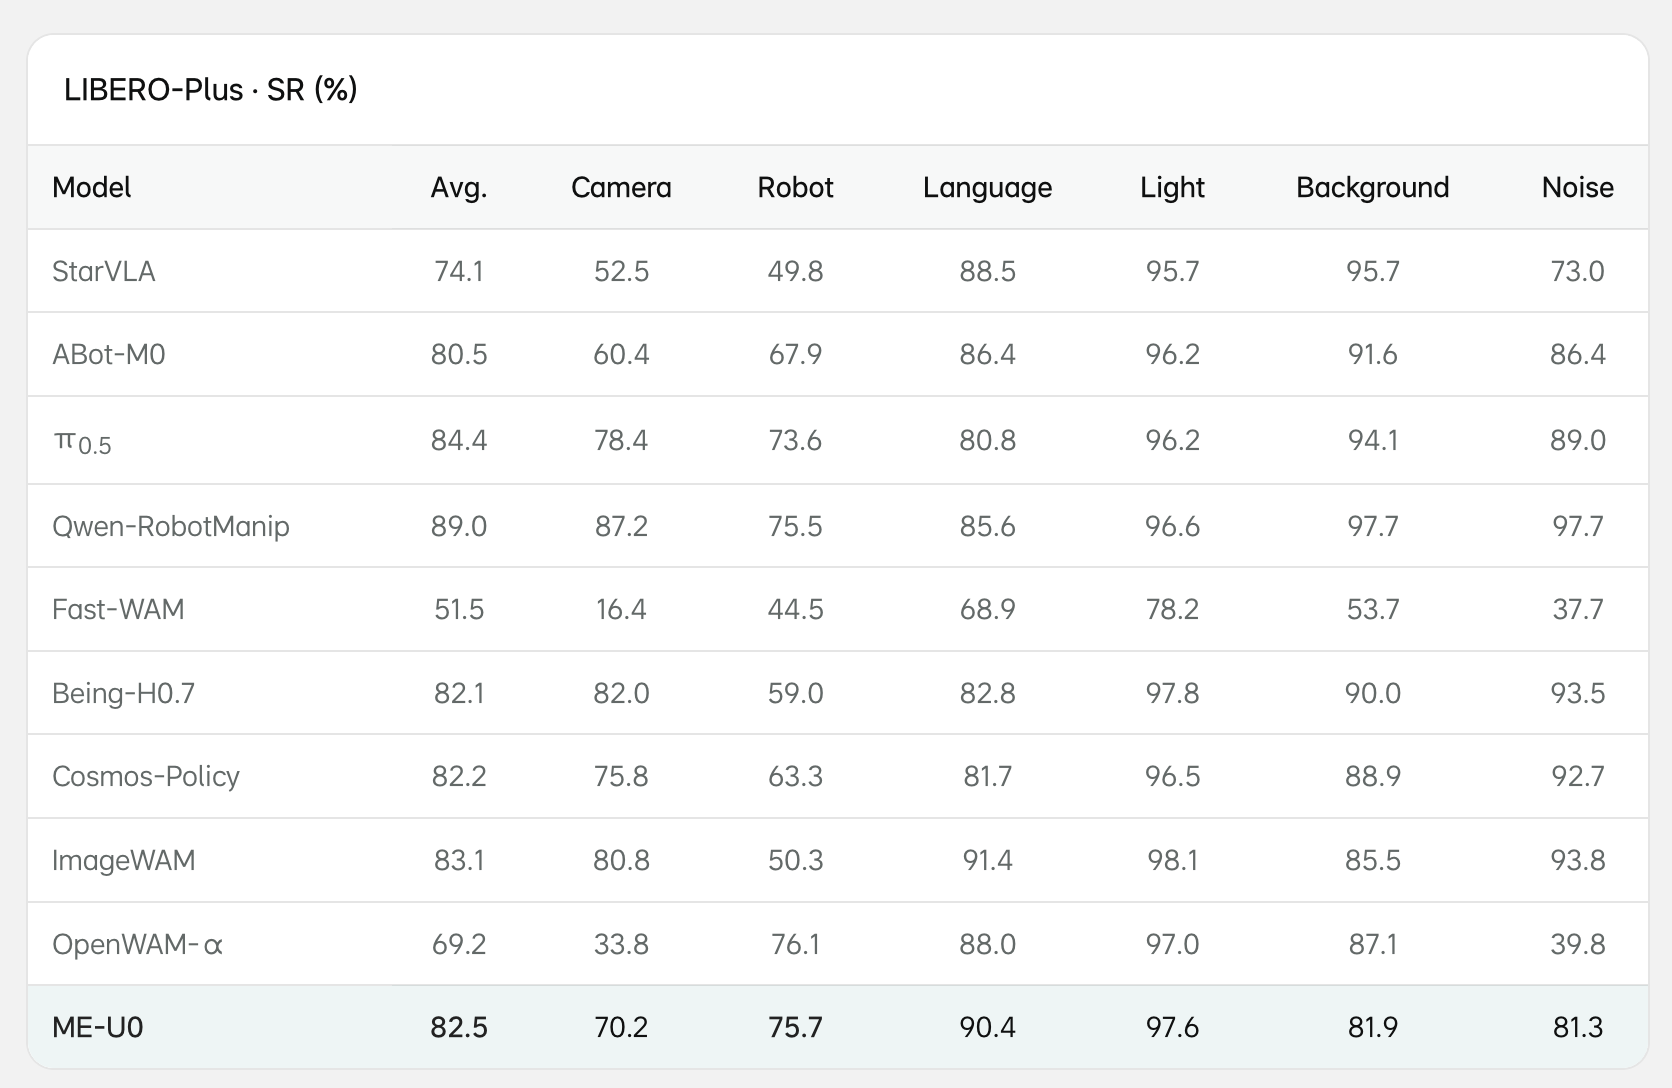
ME-U0还在标准LIBERO上取得了99.1%的平均成功率;在未针对LIBERO-Plus进行专项适配的情况下,ME-U0使用同一套权重,在10,030个扰动测试样本上取得了81.8%的平均成功率。
架构上,这一模型采用了双专家架构:
- 理解专家:子任务预测将整体指令转换为当前操作目标,可供性预测进一步识别与任务相关的物体或区域,并给出其边界框、交互方式和交互点。这些语义输出先于未来视觉与动作token生成,因而无法访问对应的监督目标,但可以为后续生成过程提供条件。
- 生成专家:共享的视频VAE和生成主干在统一潜空间中预测RGB、深度、表面法向或光流。在每个去噪步骤中,带噪视觉潜变量与动作token通过双向注意力交换信息,再经由各自的输出映射同步更新视觉动态和连续动作。
- 多速率旋转位置编码(MRPE):经过时间压缩后,每个视频潜变量时间步对应多个高频动作步。MRPE保留视觉与动作共享的时间索引,并为动作块中的每个动作分配独立的辅助位置索引,从而同时建模跨模态时间对齐关系和细粒度动作顺序。
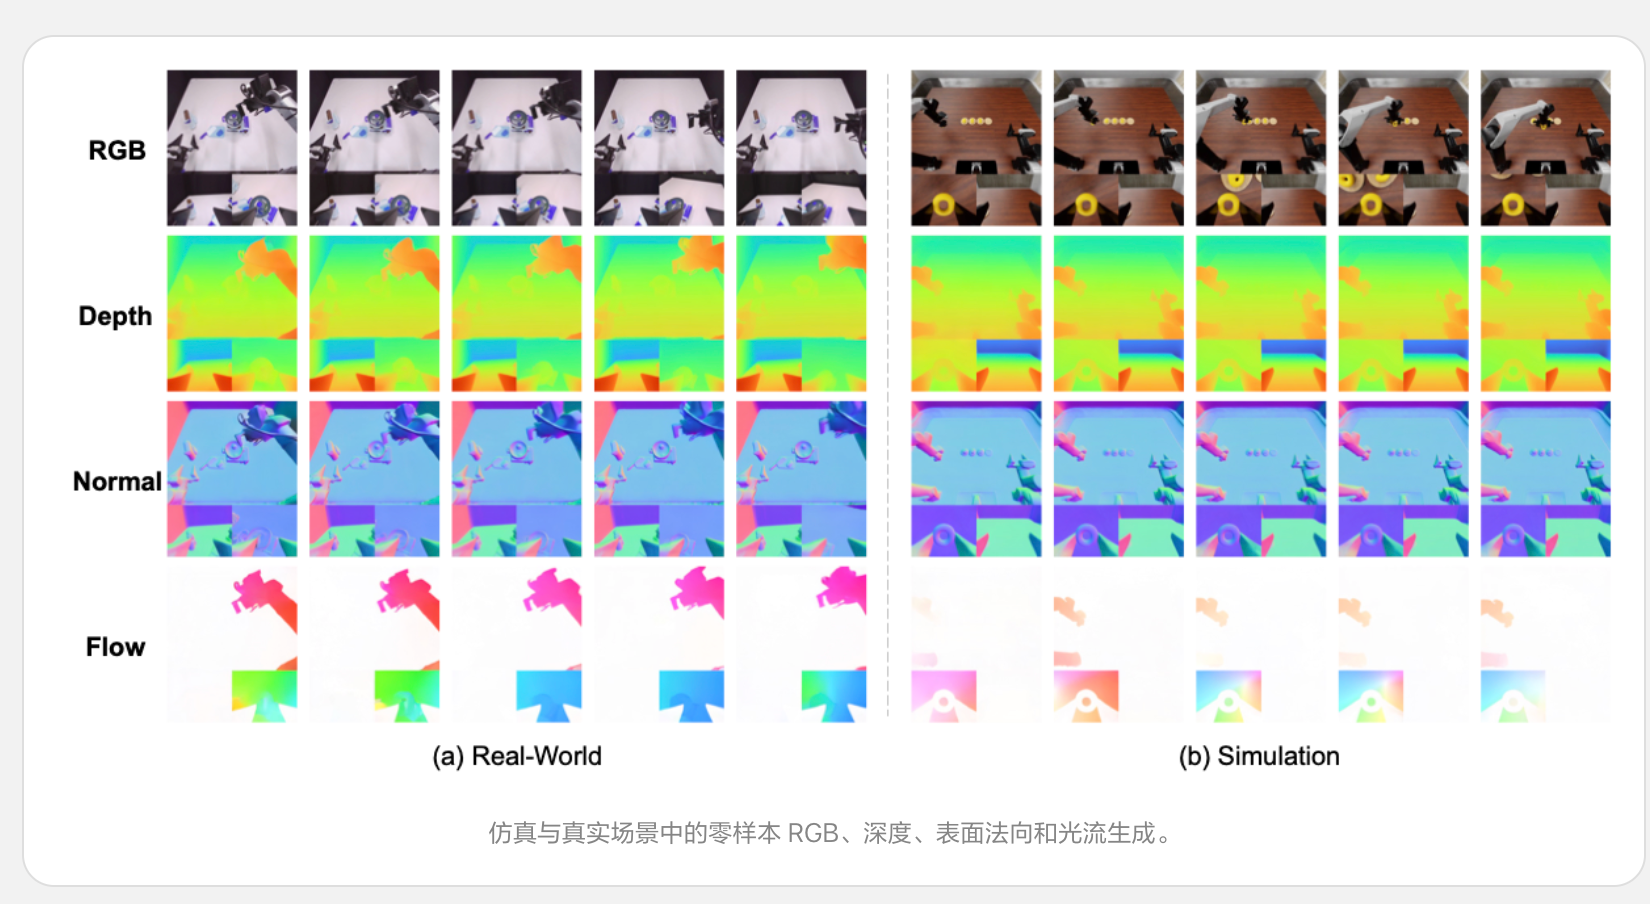
而在成果上,理想表示,这一模型拥有零样本生成和理解的能力。该公司称,无需针对特定基准进行后训练,ME-U0便可在未参与预训练的RoboDojo仿真观测和真实场景观测上预测深度、表面法向与光流。
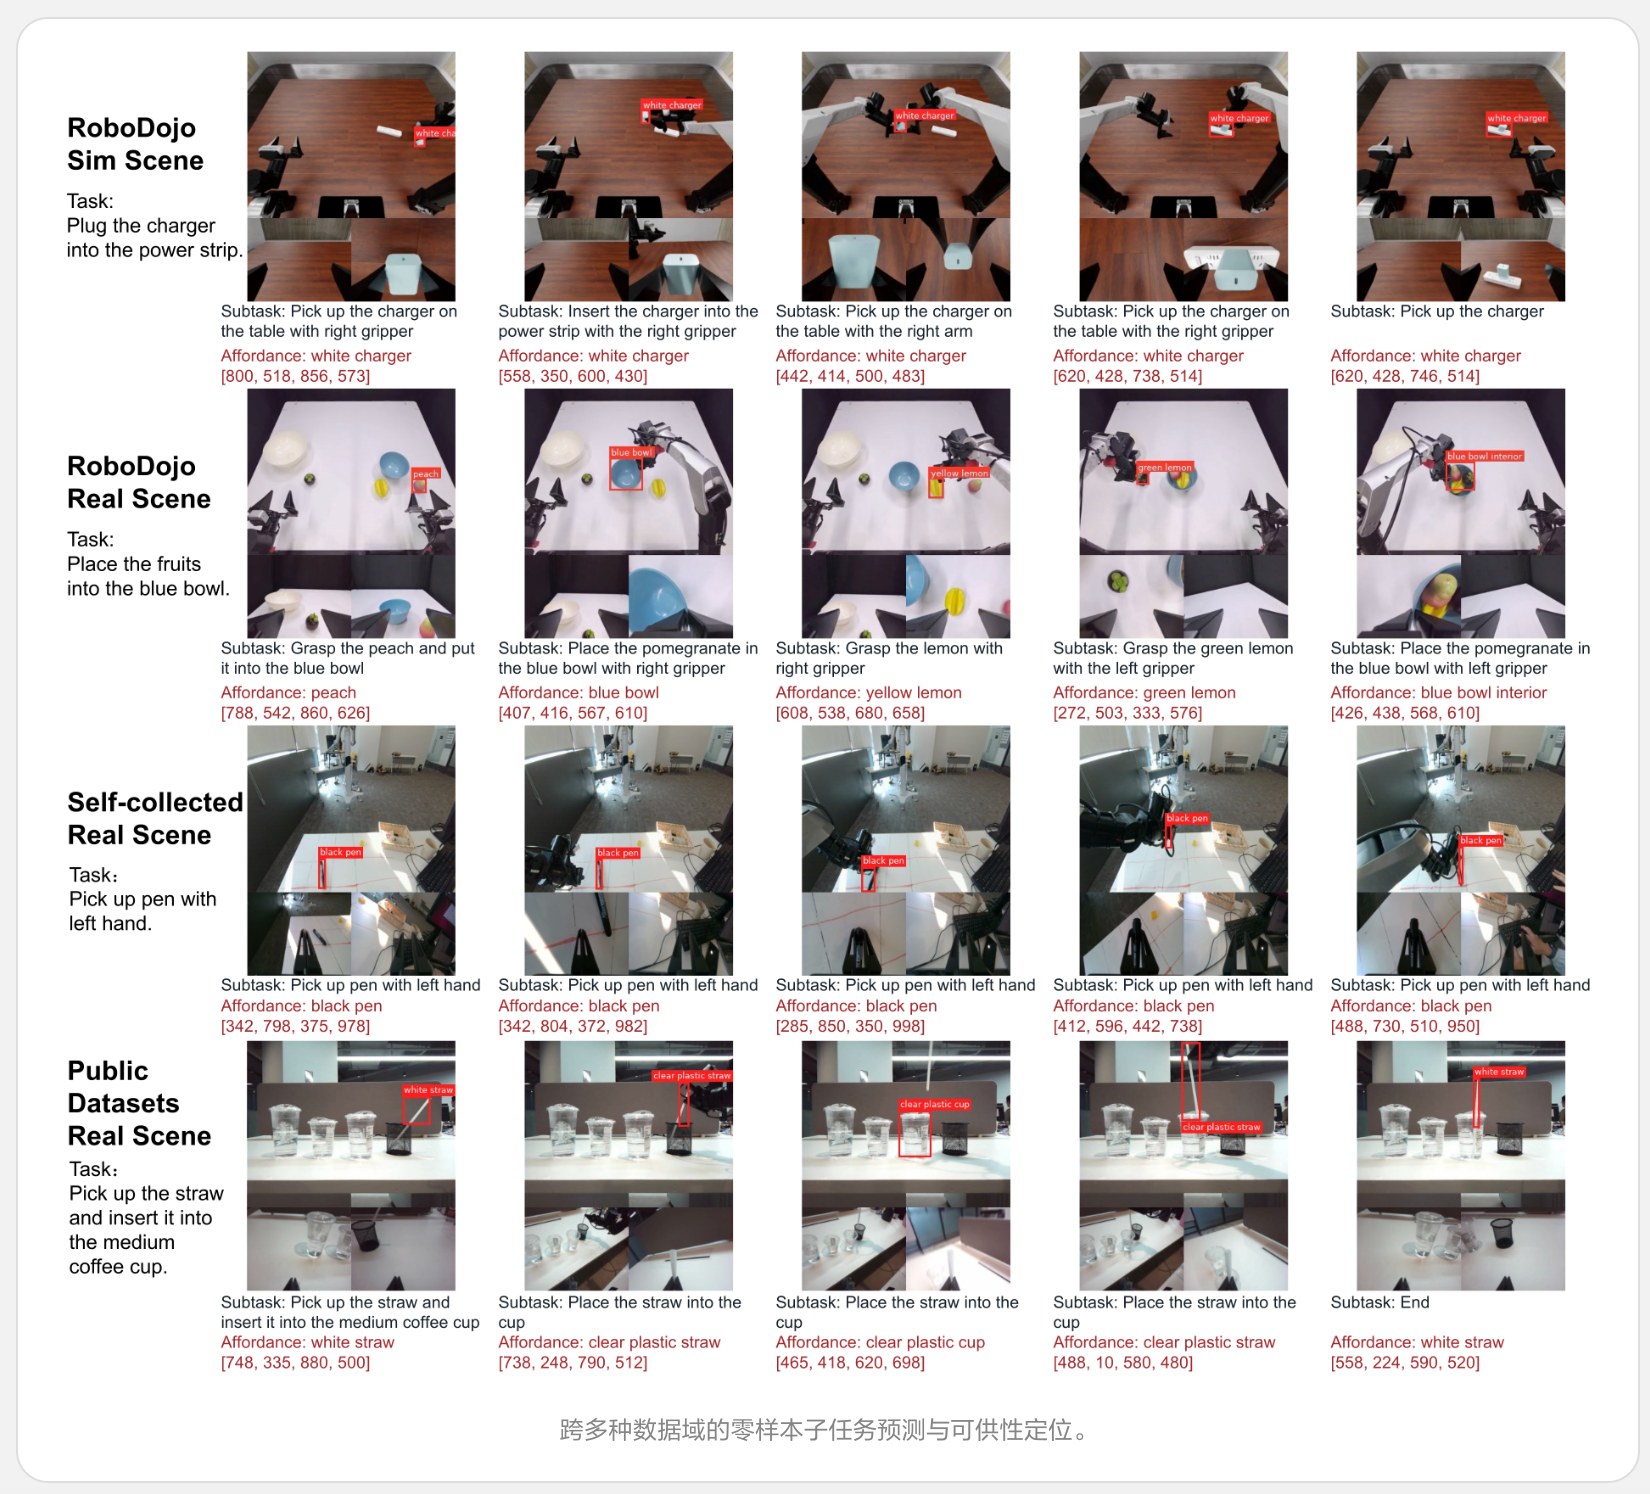
在RoboDojo、自采数据和RDT-1B数据上,理解专家还能够预测当前子任务,并通过可供性边界框定位与任务相关的物体或区域。
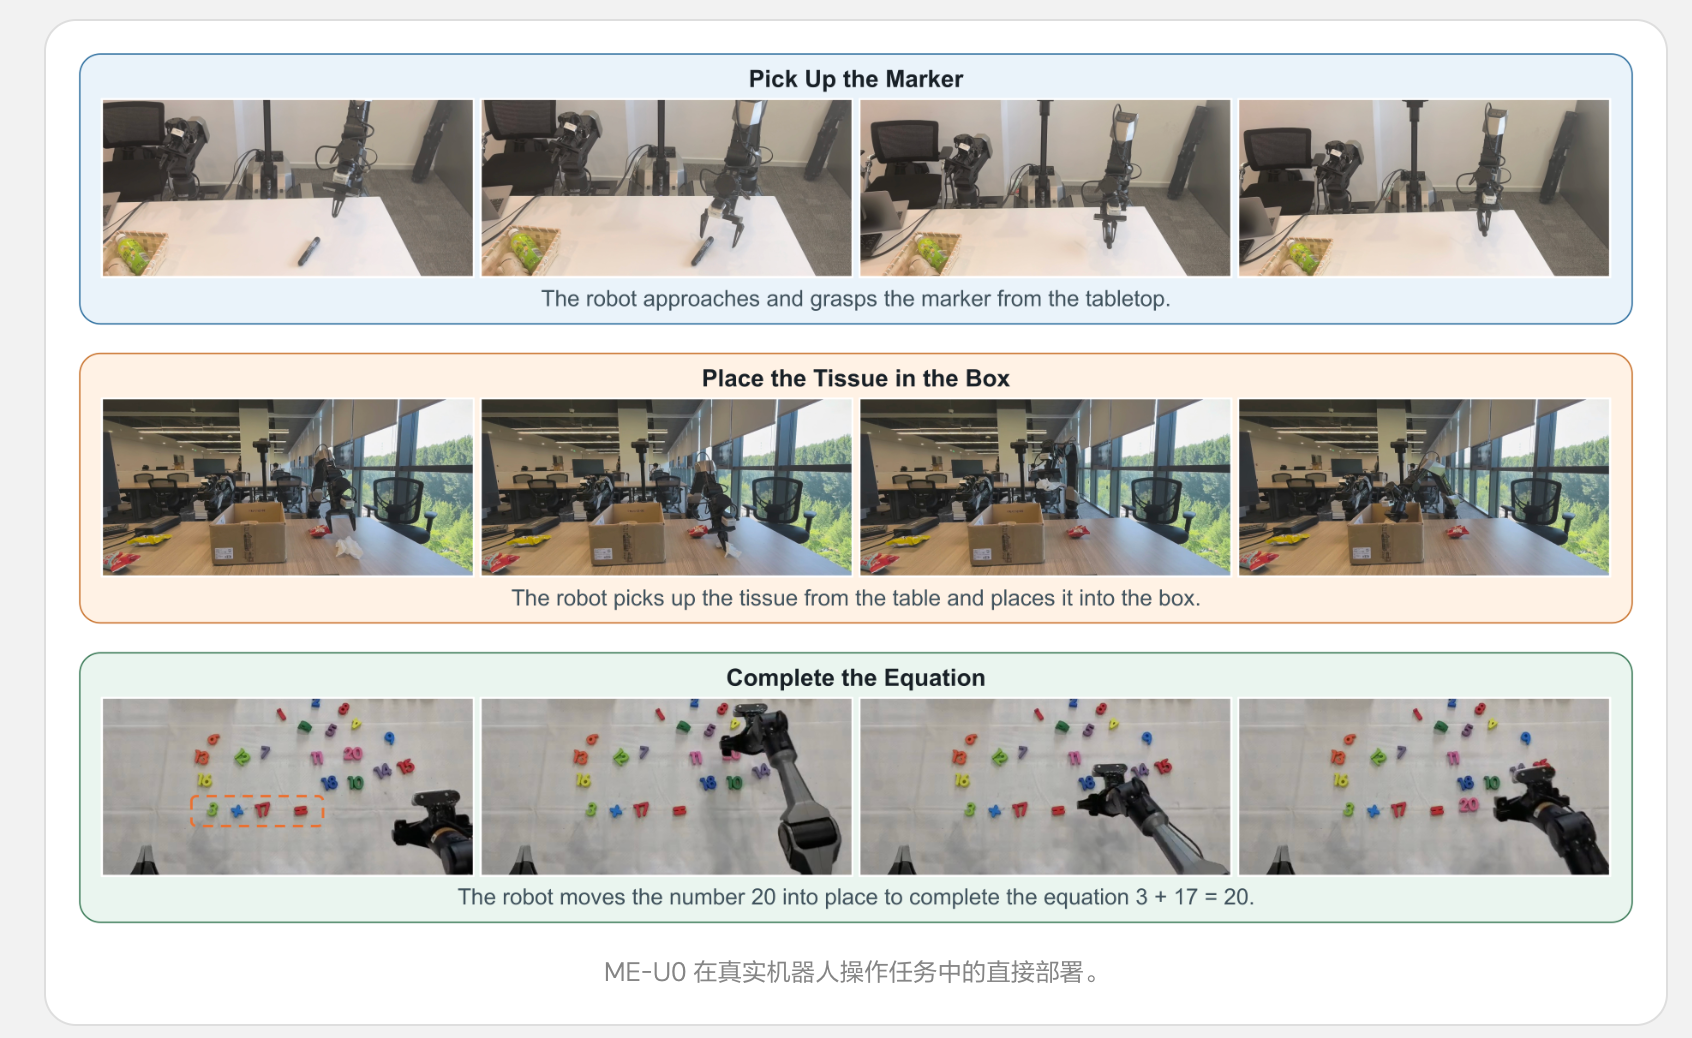
另外,理想指出,ME-U0的预训练权重无需针对具体部署任务进行额外后训练,即可直接运行在预训练数据所涵盖的机器人平台上,完成拿起记号笔、将纸巾放入盒子,以及移动数字20完成算式3+17=20三项代表性任务。
展望未来,理想表示,将在扩展数据规模与多样性、从视觉预测走向可靠执行和记忆与在线适应三方面进行持续研究。
三、推出新VLM模型,提供可端侧部署4B版本
最后,理想还推出了MachEmbodied-VLM(ME-VLM)具身认知基础模型。从技术博客来看,这一模型即为ME-Brain-1.0的Cognitive Core。
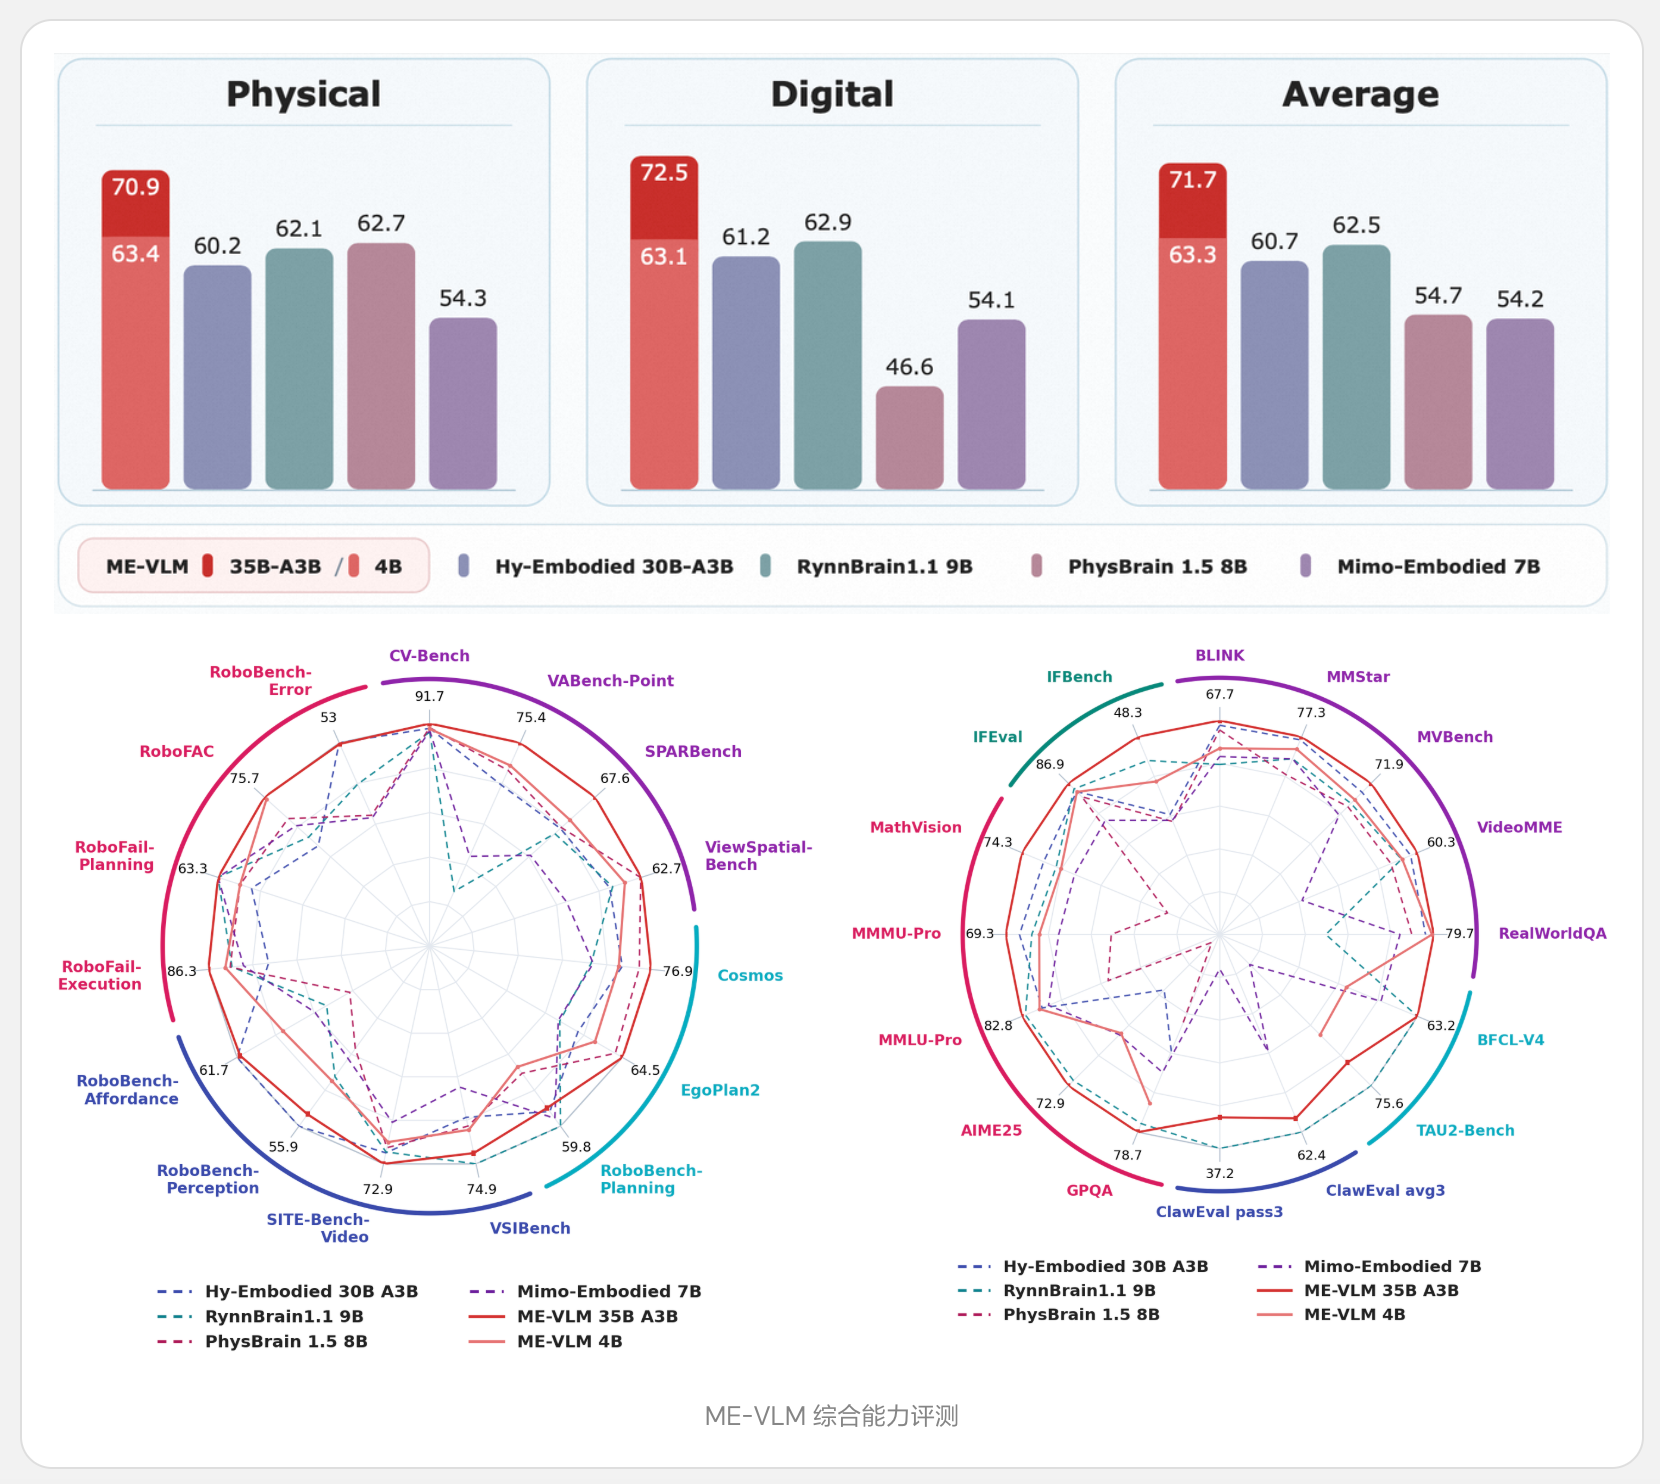
该公司表示,ME-VLM在综合能力评估中取得了第一的成绩。同时理想也提供了可端侧部署的4B版本,在小参数规模下取得了较好指标。
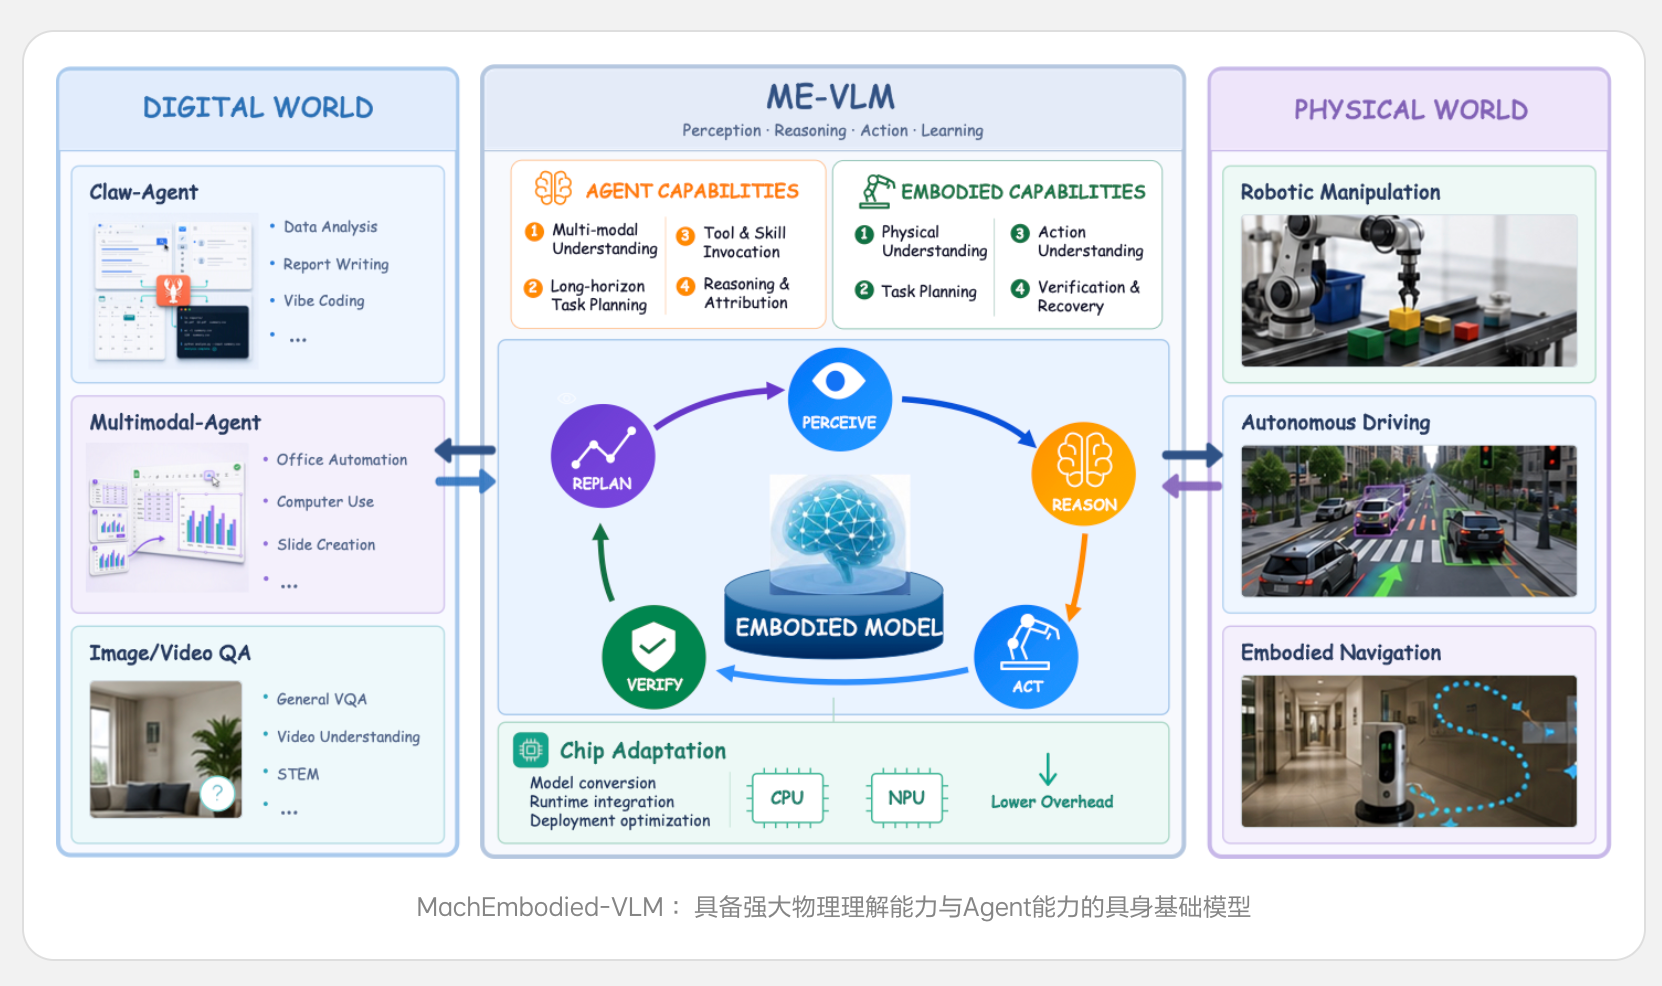
在能力框架上,该模型围绕观察—规划—行动—验证形成任务闭环。具身认知提供物体、空间关系与动作约束;Agent能力负责目标拆解、技能调用和上下文维护;执行后的物理观测则持续校正后续决策。
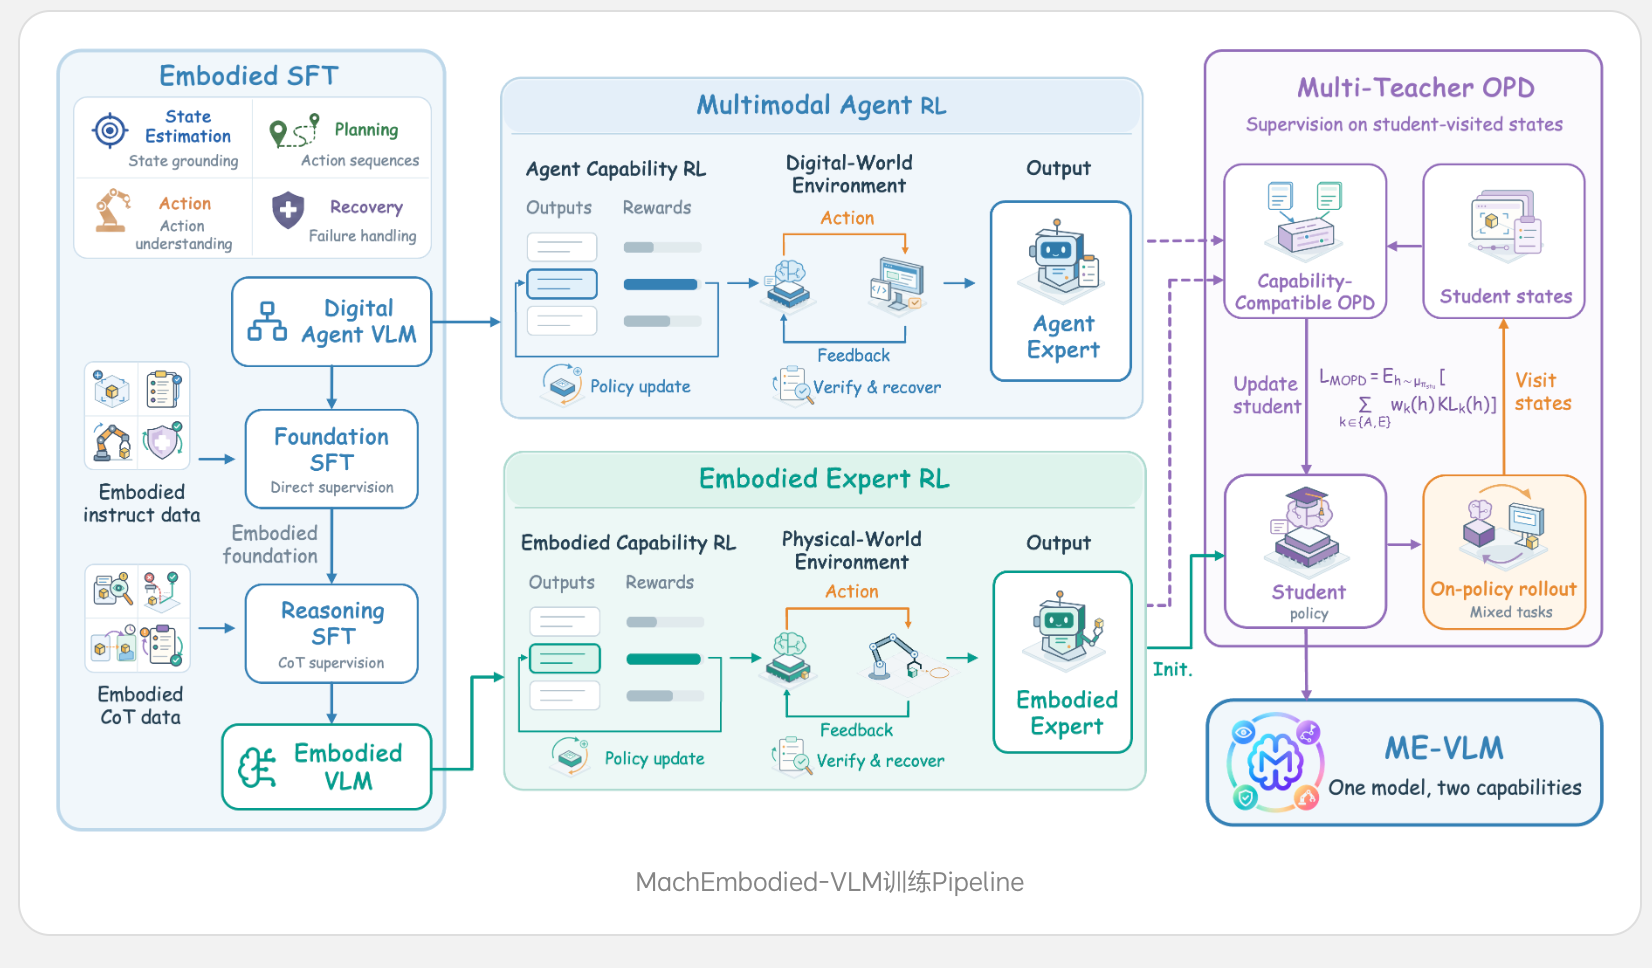
理想将这一模型训练过程组织为三个相互衔接的阶段:首先通过SFT训练注入具身能力;随后在能力单元和环境闭环两个粒度上实施专家强化学习,分别获得多模智能体专家与具身认知专家;最后采用多教师在线策略蒸馏,将两个专家的互补能力融合到一个以具身能力为锚点的学生模型中。
在端侧部署上,理想将ME-VLM 4B部署在自研SoC M100上,基于基座模型Token压缩技术和W4A8量化方案,可将Prefill阶段参与后续计算的Token数量从4096降低至3328。部署实测中,该协同优化将Prefill推理时延从400ms下降至188ms,时延降低约53%,实现约2.13×的Prefill加速比。
因其评测和ME-Brain-1.0中Cognitive Core 35B-A3B和4B的结果一致,此处不再列举。不过,理想还对具身导航和自动驾驶两项能力进行了评测,这两个规模不同的模型均取得了较好结果。
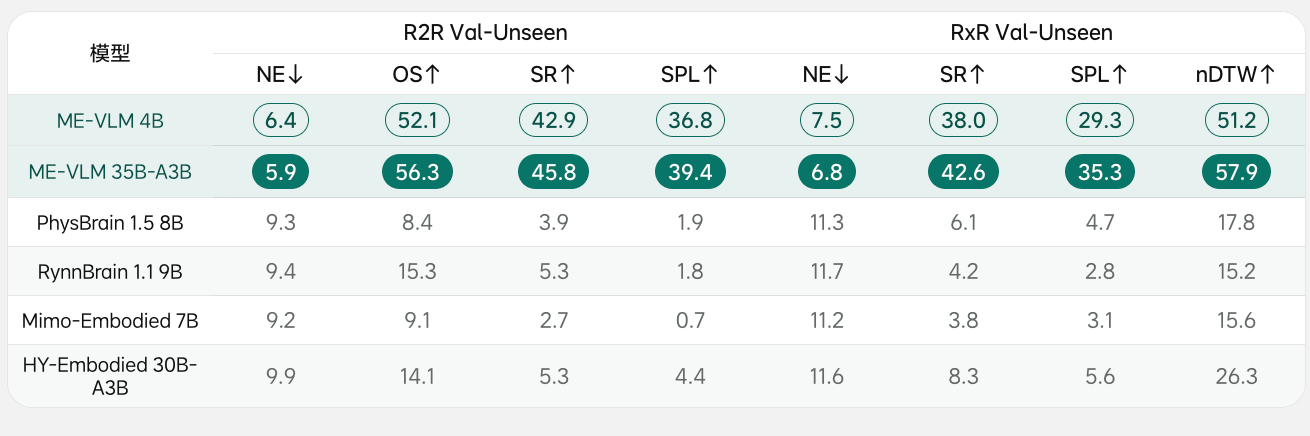
具身导航方面,ME-VLM 35B-A3B在R2R Val-Unseen与RxR Val-Unseen的全部8项指标上均居榜首,面向端侧的4B模型在两项基准上的SR分别达42.9%和38.0%,各项指标的同样优于所有外部基线。
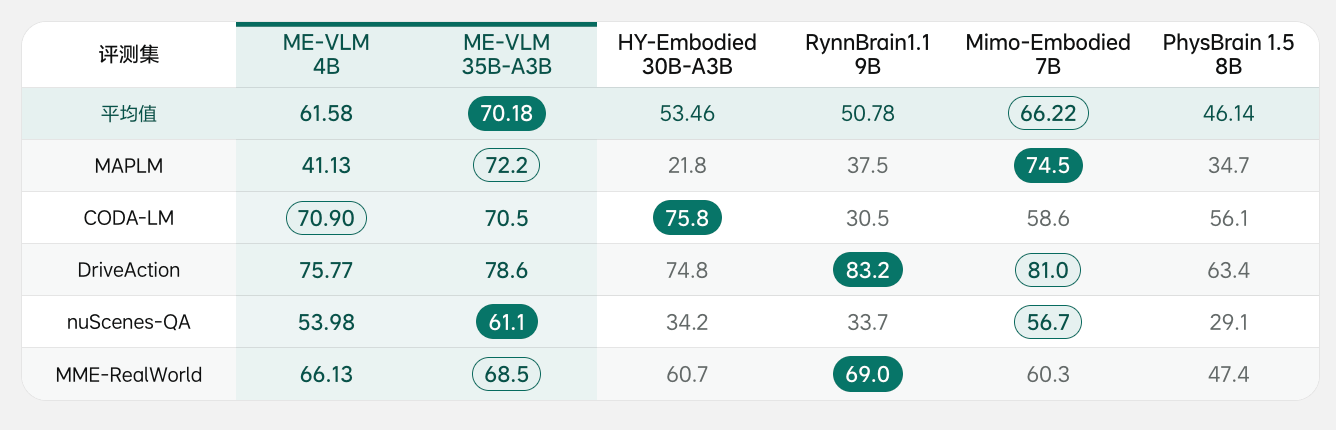
自动驾驶方面,在MAPLM、CODA-LM、DriveAction、nuScenes-QA与MME-RealWorld五项基准上,ME-VLM 35B-A3B以平均70.18分居首位,面向端侧的4B模型平均分为61.58。

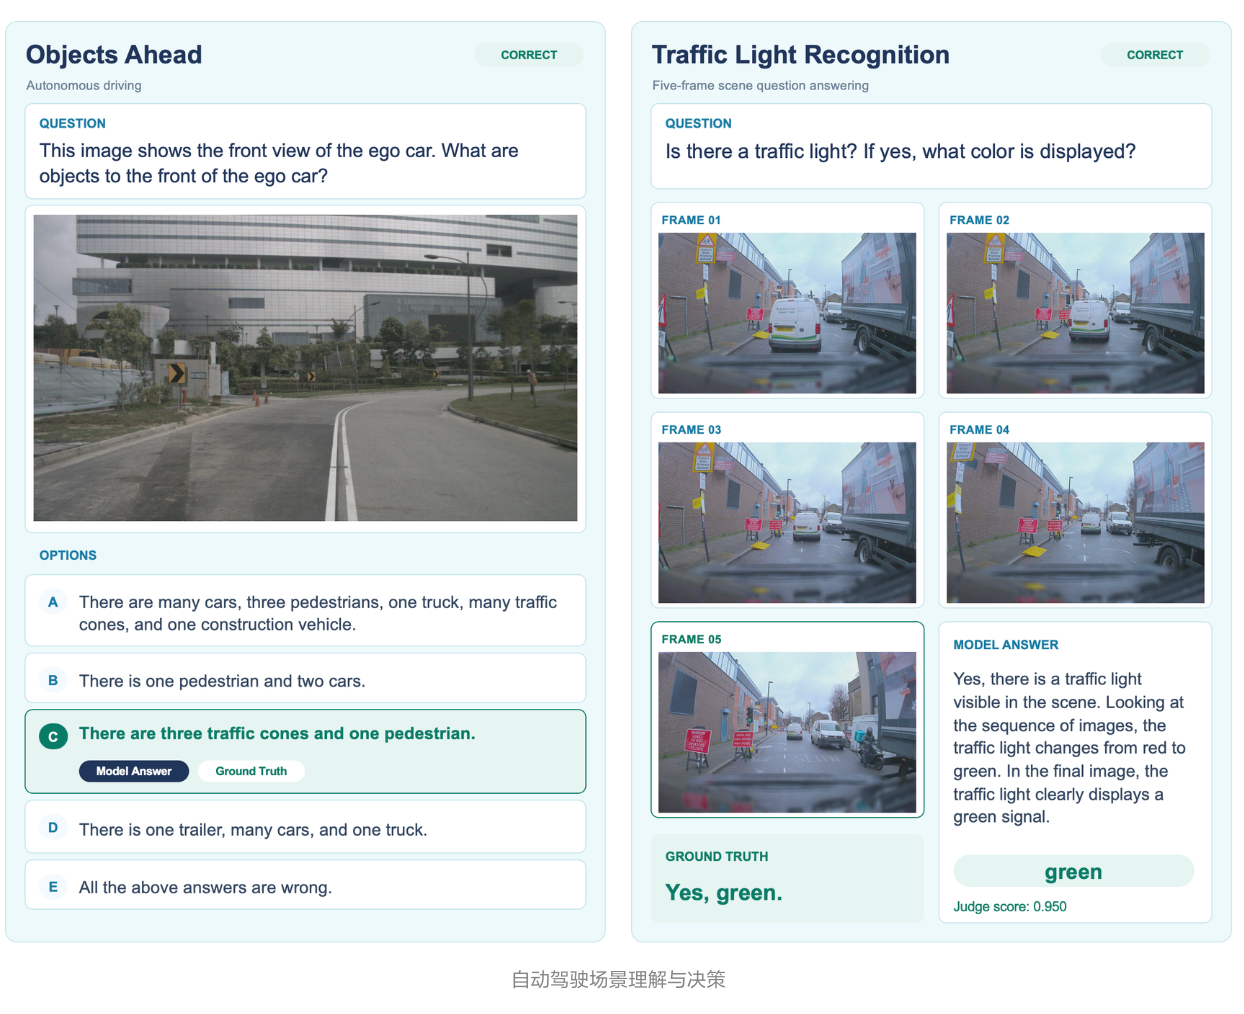
在场景应用上,理想称,该模型可用于决策流式感知与主动响应、自动驾驶场景理解和具身导航任务等。
结语:想把模型拼成能力,但要看实际落地效果
一天之内连发系统、统一模型与VLM,理想显然想把“单点能力”拼成“体系能力”。从纸面指标看,ME-Brain-1.0、ME-U0、ME-VLM各有拿得出手的成绩;但从演示细节看,停顿、失误、开放任务偏弱、耗时偏长等问题也还真实存在。
具身智能的竞争,现在已经从有没有模型转向模型能力、落地能力的比拼。理想这次交的是一份体系化的答卷,但答得好不好,最终还是要回到真机实测、长时序任务和开放环境里持续检验。
ME-Brain-1.0技术博客链接:https://machembodied.com/ME-Brain/ME-Brain-1.0.html
MachEmbodied-U0技术博客链接:https://machembodied.com/ME-U/ME-U0.html
ME-VLM技术博客链接:https://machembodied.com/ME-Brain/ME-VLM.html
(注:头图由AI生成)
