

智东西(公众号:zhidxcom)
作者 | 王涵
编辑 | 漠影
就在上周,Salesforce正式上线了一批“job-ready”(即用型)长周期智能体。
销售Agent Hunter可以跨天、跨周持续跟进一个销售机会——自己做研究、写邮件、调整策略、更新CRM,直到目标完成或需要人类决策;
客服Agent Casey能在语音、短信、WhatsApp、网页等多渠道自主处理问题;还有专门负责线索生成、IT/HR服务、供应链的Agent等等。
进入2026年,Agent成为大热赛道,国内外的办公、生活Agent产品如雨后春笋般涌出。Agent在生活中越来越普及,用户看到的,是“一句话就能把复杂工作交给Agent”的便利。
而产业看到的,是账单。
国际数据公司IDC近期发布《DAA研究报告》(Daily Active Agents,日活智能体数)。报告显示,2025年,全球活跃Agent数量是2860万个,预计2026年达到7940万个,2030年将增长到22.16亿个。
Agent全民化的趋势不可挡,但你有没有想过,如此大的吞吐量,Agent背后到底靠什么支撑?
水面之上,是“一句话办事”的便利。水面之下,则是芯片、存算、互连、系统、框架、Infra共同支撑的计算体系。Agent每一次规划、每一轮推理、每一次工具调用,最终都要落到这套体系上。
最形象的例子就是不久前全球最大开源模型Kimi K3的发布,该模型在发布48小时内因算力逼近极限,月之暗面暂停了新用户订阅。
Agent和模型能力飞速进化,其背后的计算体系有四个痛点越来越棘手:
1、Token消耗巨大,算力成本与稳定性风险
2、芯片架构追不上Agent负载的变化
3、芯片多元了,软件怎么协同?系统能力怎么扩展?
4、Agent进入生产系统,稳定供给和可靠运行没有标准答案
这四个痛点如何解决?行业亟须一个机会,让模型、芯片、存算、互连、系统、框架、Infra等Agent产业链上的每一环坐在一起好好聊聊。
这不,机会来了。
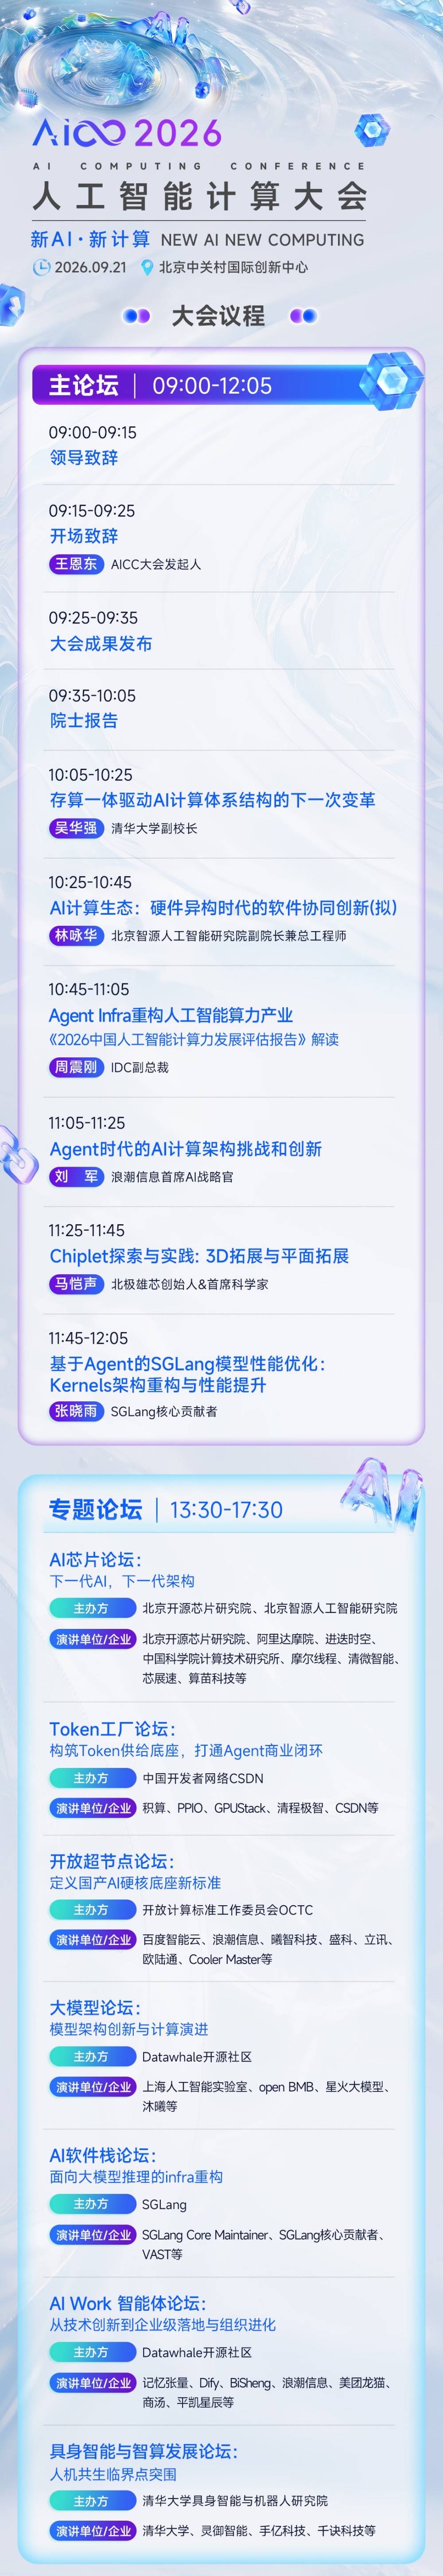
2026年9月21日,AICC2026人工智能计算大会将在北京中关村国际创新中心举行,本次大会设置1个主会场、7个分会场,近60场专题报告。
届时,来自芯片/存算/互连/系统/框架/Infra/模型等领域的专家和学者,将共同探讨“当Agent从一次调用走向持续任务链,下一代AI究竟需要怎样的计算体系”。
一、Agent越在线,算力越像“无底洞”
据Gartner 2026年3月报告,一个Agent工作流每任务消耗的Token量是标准聊天机器人的5到30倍,原因是单次用户请求通常会触发10到20次顺序模型调用。
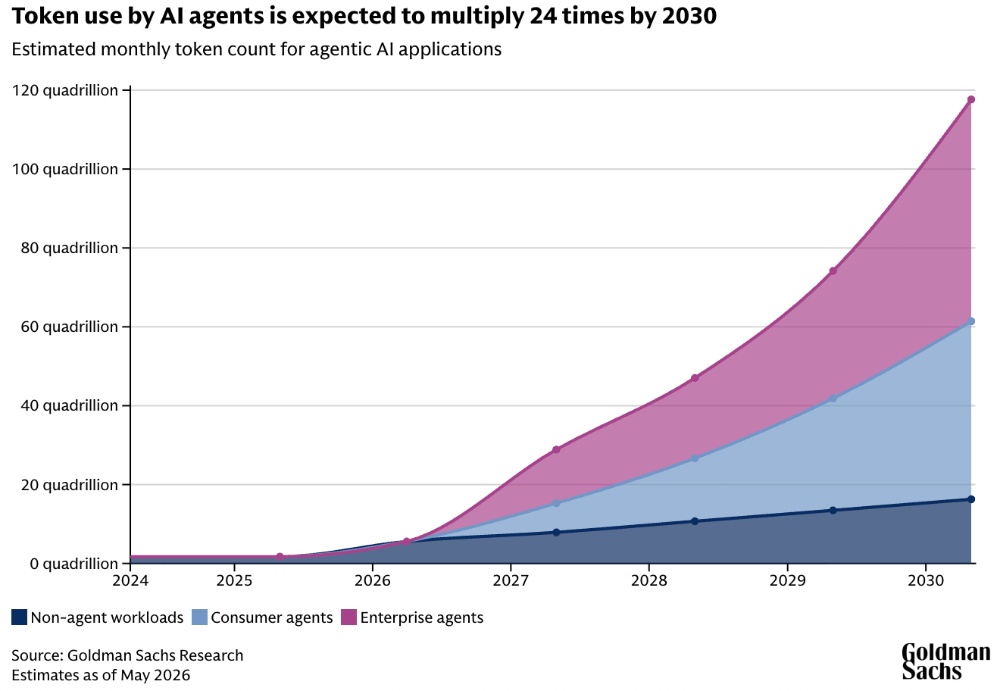
高盛预测,到2030年全球Token消耗量将较2026年增长24倍,达到每月约120000万亿Token;持续在线的智能体每天Token消耗可能超过10万。
这还只是Token层面的消耗。更底层的问题是:支撑Agent运行的大模型本身,正在变得越来越大,越来越难跑。
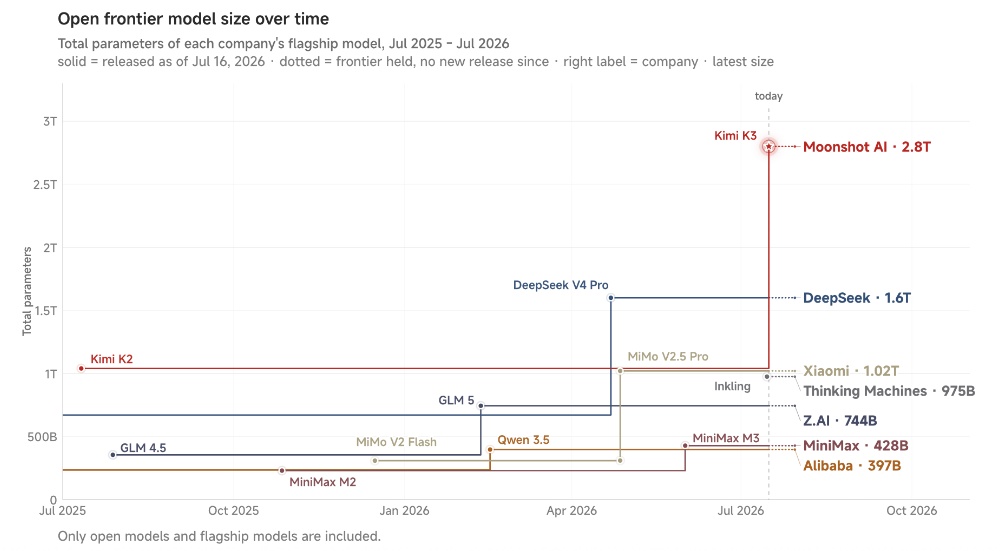
以全球最大开源模型Kimi K3为例,该模型总参数量2.8T、激活参数量104B。K3权重文件约1.56TB,而普通的AI服务器,GPU显存连权重都装不下,更别提百万Token上下文,因此官方推荐扩展到64卡甚至更大规模才能装得下。
即使装得下,对算力系统显存带宽与节点间通信要求也极高。据SemiAnalysis 的分析,K3每执行一次前向计算,仅HBM带宽需求就高达约1.5TB;896个专家需要分布到多卡上,每次前向传播触发超过120次All-to-All通信。
这意味着,如果互连带宽和延迟跟不上,大量算力就会被浪费在等待多卡之间的数据搬运上。
此外,Kimi K3采用KDA(Kimi Delta Attention)线性注意力与全注意力相结合的混合架构,需要专门的线性注意力融合算子、分块并行策略以及状态感知的缓存管理机制。未经优化的超节点系统,初始性能可能仅在10 tokens/s左右。
万亿参数模型正在让传统AI算力系统遭遇瓶颈。
问题不只是芯片算力够不够,更在于模型能不能放下、数据能不能高效搬运、多芯片能不能协同起来。当Agent从偶发请求走向持续在线,算力供给和成本控制怎么做?
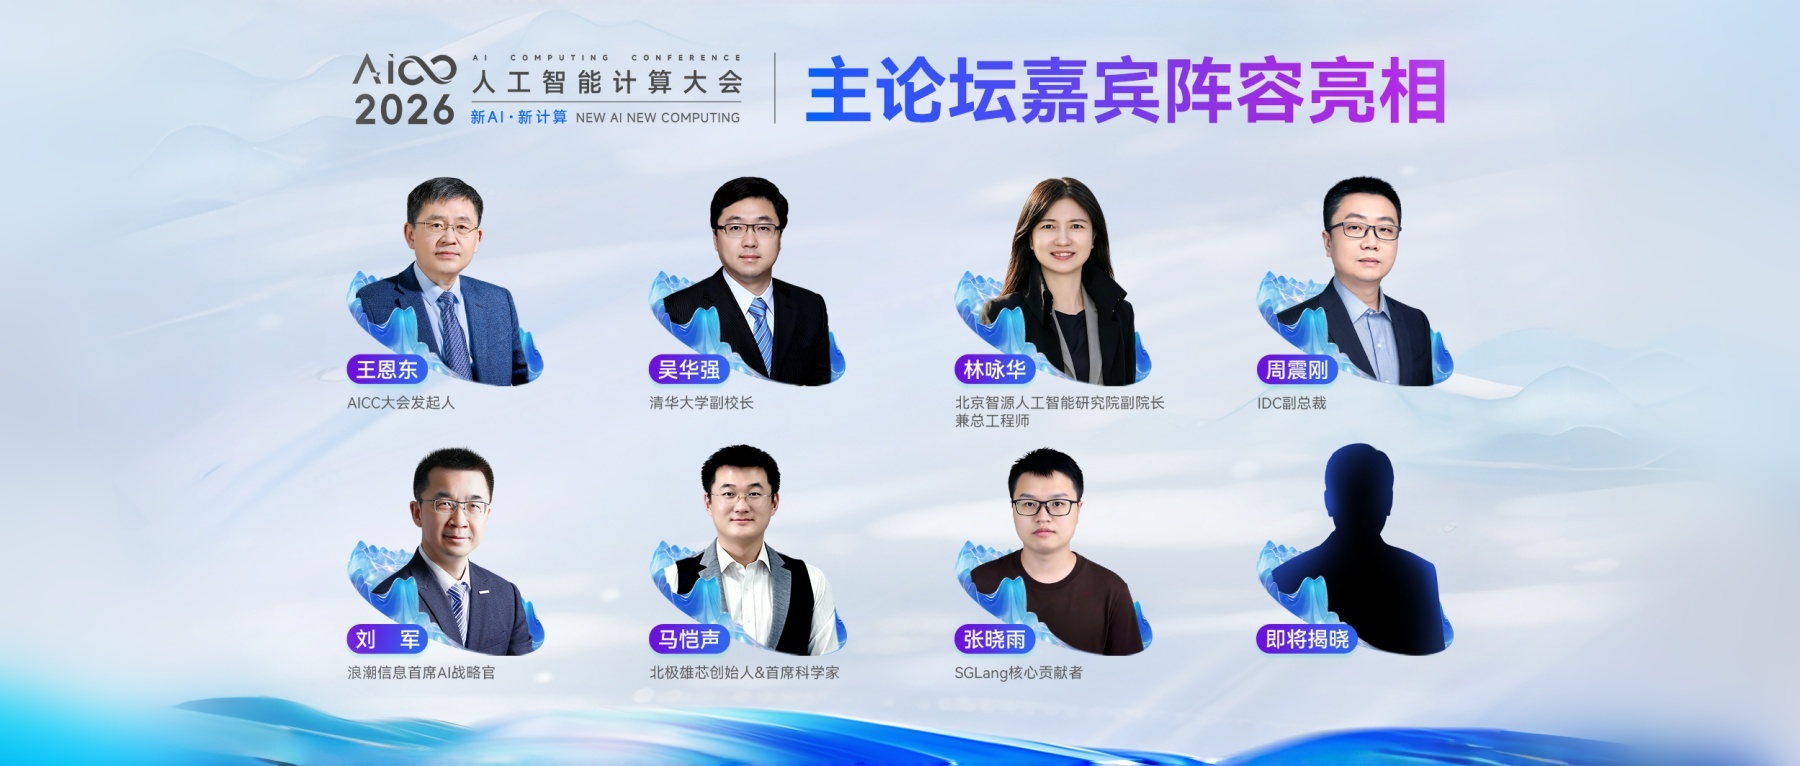
这正是AICC2026主论坛上多位嘉宾将要回应的问题。
在系统侧,浪潮信息首席AI战略官刘军将回应算力如何从“堆得更多”走向“用得更好”,通过开放多元的系统架构,以及计算、互连、存储、软件的协同创新,让每一份算力算得其效、算尽其用。
在模型侧,AI Infra论坛上,由SGLang核心维护者主导,将讨论大模型推理的基础设施重构问题。SGLang核心贡献者张晓雨也将在主会场分析Agentic Inference如何通过Kernel、缓存和调度降低时延与成本。
此外,在OCTC主办开放超节点论坛上,百度智能云、浪潮信息、曦智科技等将共同讨论国产AI硬核底座标准。
Token工厂论坛上,GPUStack、硅基流动、清程极智、PPIO、积算科技等团队将拆解推理供给的商业闭环。
这些议题共同指向同一个答案——Agent越在线,算力越不能“掉线”。
面对持续增长的Token需求,除了多堆芯片,行业还需要更高效的模型框架、更开放的芯片互连,以及更深入的算子优化等系统创新,把算力转化为更快、更稳定、更低成本的Token。
二、Agent负载发生变化,传统芯片遇上两堵墙
Agent负载变长、并发增加、时延层层累积,传统芯片架构面临“存储墙”“功耗墙”与制程瓶颈。
传统冯·诺依曼架构下,存储与计算分离,数据在两者之间来回搬运,功耗和时间大量消耗在搬运路上。而Agent负载恰恰对这一点格外敏感。
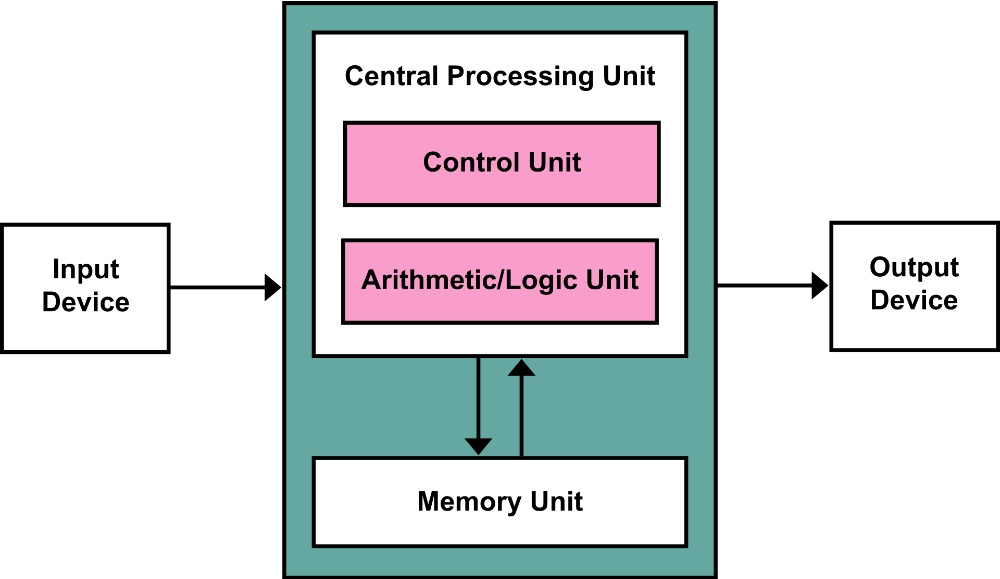
清华大学副校长吴华强将在AICC2026主论坛上讨论一个关键命题:存算一体能否重构计算架构,让计算在存储之处发生?
Agent所承载的工作越来越复杂,芯片的能力开始触及边界,行业也开始探索更多新架构来扩展芯片能力。
例如,北极雄芯创始人&首席科学家马恺声就将在大会上拆解Chiplet与3D集成如何拓展芯片能力边界。
北京开源芯片研究院和智源联合主办的AI芯片论坛,将阿里达摩院、摩尔线程、中科院计算所等机构聚在一起,共同思考:当摩尔定律逼近物理极限,除了把晶体管做小,从材料、架构、封装等多个维度,芯片还有哪些新的可能?
三、硬件路线越来越多,系统却越来越难统一
芯片架构正在从单一走向多元——存算一体、Chiplet、3D集成,每条路线都在试图接住Agent带来的复杂负载。
但一个问题随之出现:不同芯片有各自的软件栈和生态,应用要在多种硬件上运行,迁移和适配成本居高不下。
芯片路线越来越多,怎样才能进入同一个系统,形成整体能力?硬件路线越来越多,软件如何协同,不同芯片又怎样形成可扩展的系统能力?
这个问题不仅存在于技术层面,它更是一个决定Agent能否规模化落地的产业问题。
主会上,北京智源人工智能研究院副院长兼总工程师林咏华将讨论硬件越来越多元,软件如何让不同芯片真正协同起来。
她主导的FlagOS项目,正是一个面向异构AI芯片的开源统一系统软件栈,目标是“一次开发,多芯运行”,目前已支持18家厂商32款芯片。
在这条路径上,软件栈扮演的是“翻译层”的角色——让上层应用不必关心底下跑的是什么芯片,让不同架构的芯片都能进入同一个系统。
四、Agent要“持续办事”,可靠性、评价尺度、企业落地谁来管?
在进入消费者生活的同时,Agent也“打”入了企业内部。
在企业中,Agent更要持续在线、稳定执行,企业级落地对其算力能力、使用成本与稳定供给提出了新要求。
据网易有道LobsterAI发布的《中国办公Agent用户行为不完全报告》,办公Agent单次任务规模在5个月内增长3.1倍,8月环比增幅高达53%,用户正在将更加复杂、长周期的深度工作托付给Agent。
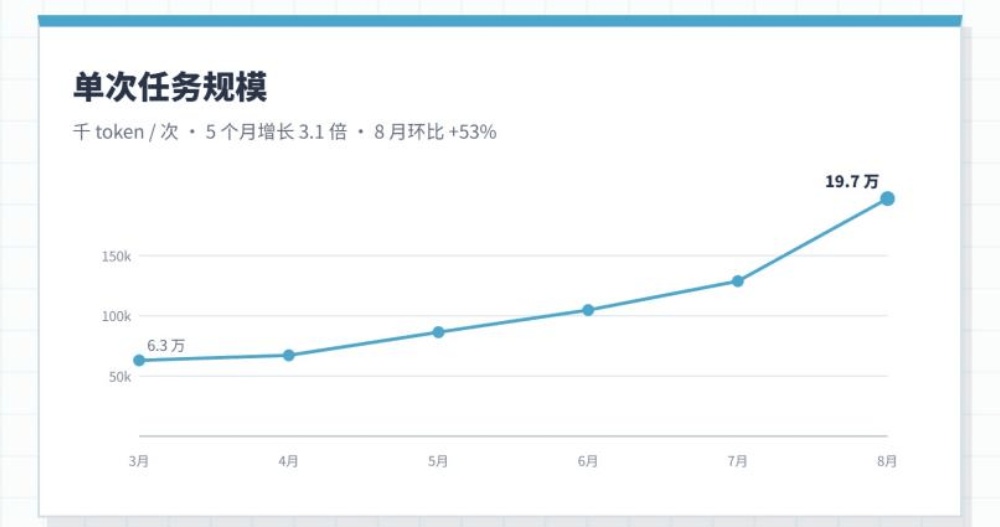
Agent在企业办公中的角色越来越重要,但对其算力评价的尺度仍停留在算力规模和单点性能,尚未走向系统能力、计算效率与应用价值。
Agent时代,哪些行业正在率先把Agent能力转化为业务价值?Agent的能力又该如何衡量?这正是AICC2026两个重磅发布仪式的意义所在。
在大会上,IDC与浪潮信息将联合发布《2026中国人工智能计算力发展评估报告》,这是业内首份Agent基础设施算力研究报告,将系统呈现面向Agent时代的AI基础设施变革与重构,并揭晓2026年度中国AI算力城市最新排名。
另外,一套覆盖“芯片—框架—模型—应用”的AI测评体系也将同期重磅亮相,填补国内AI第三方评测空白。
AI Work论坛上,Datawhale主办,Dify、记忆张量、平凯星辰、商汤等团队将讨论智能体从技术创新到企业级落地。
Agent要真正进入日常和生产,不能只靠“能跑”,还要“可靠地跑、算得清账、评得出价值”。
结语:看懂中国AI计算的下一步,听AICC2026这一场大会就够了
智能体正在从技术创新走向产业实践,计算体系也随之从后台支撑变为决定AI能否规模化、可持续、可负担的关键变量。
产业需要的,或许不仅是某一层的单点突破,而是芯片、系统、软件、应用之间更紧密的协同演进,以及开放、多元、可验证的产业生态。
如何突破?如何协同?新AI时代需要的是怎样的计算系统?这些问题的答案,都可以在AICC2026人工智能计算大会上找到。
大会完整议程: